04a · 候选证据参考
多数主参考单元缺乏充分文本证据。
候选参考将 2,744 个主单元中的 2,273 个判为证据缺失或部分证据。充分证据比例随来源存在很大差异;这是对处理后对话与当前证据参考的描述性结果。
- 证据缺失或部分证据
- 82.8%
- 分母为候选参考下的 2,744 个主单元;其中 2,273 个属于这两类。
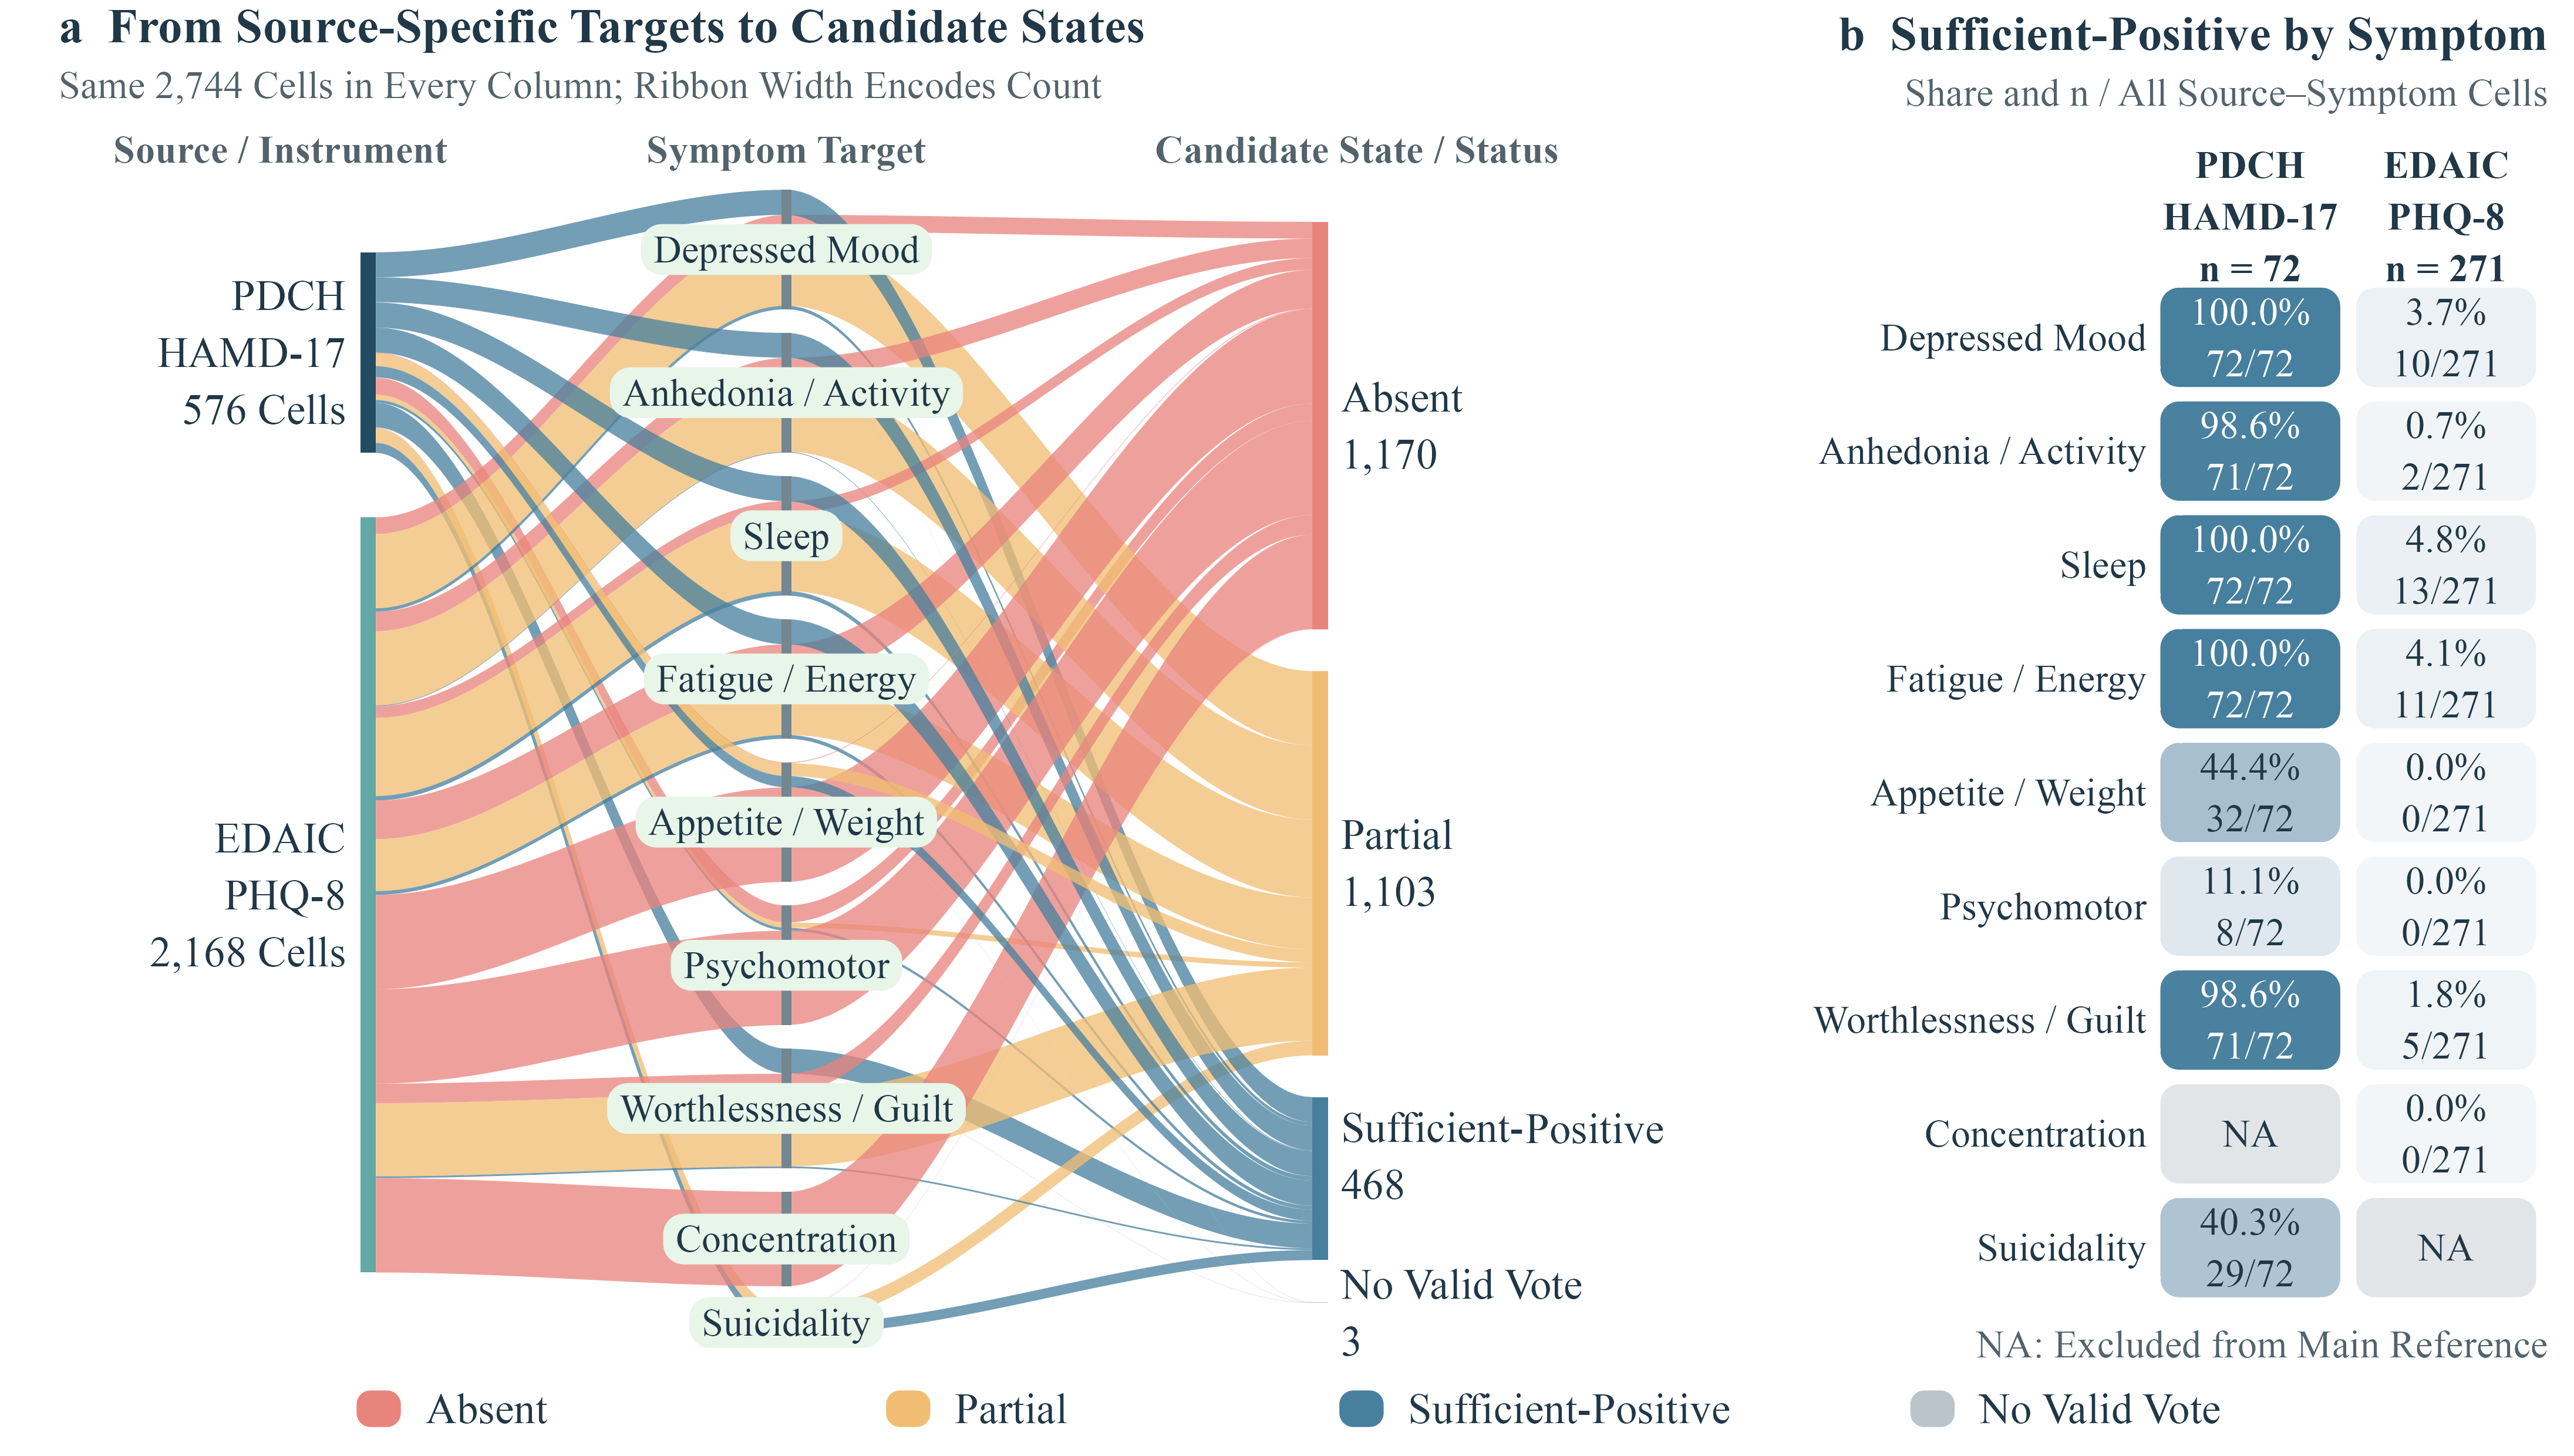
2,744 个主单元的候选参考证据状态。带宽表示单元数;来源与症状的比例以对应全部单元为分母。NA 表示按设计排除的维度。
查看原图Ground · 研究基准
更新
模型预测与症状标签一致,并不一定意味着访谈提供了足够依据。EviDial 将文本证据支持作为独立维度,帮助抑郁对话评测区分“标签答对了”与“判断有依据”。
01 · 研究问题
以睡眠评估为例:访谈从未讨论睡眠,而基准标签为“无睡眠障碍”。模型只要预测这一标签,就可能得到正确分数,即使对话没有提供支持这一判断的证据。
示意案例 · 睡眠障碍
访谈从未讨论睡眠。
“无睡眠障碍。”
预测与基准标签一致。
对话不足以支持这一判断。
EviDial 同时追问:预测是否匹配标签,对话是否支持它的判断方向?这有助于识别需要弃答或进一步询问的情形。
02 · 独立的证据维度
每个“参与者 × 症状”单元按照明确规则获得证据状态。多个评审提供候选判断;参考构建与测量审计用于揭示这些判断本身的不确定性。
核对主体、时间范围、断言范围及撤回后,没有可用证据。
存在相关证据,但尚不足以确定目标症状存在或不存在。
有效证据相互矛盾,无法形成一致判断。
有效证据足以支持一个明确方向:症状存在或不存在。
缺少证据不意味着症状不存在。这些状态描述可用文本,而非参与者的临床状态。
03 · 基准范围
EviDial 汇集 PDCH、E-DAIC 与 TalkDep 的中英文对话记录。主临床参考池为每位 PDCH 参与者选取一次访谈,并排除模拟人物。
| 来源 / 量表 | 记录数 | 主池参与者 | 范围说明 |
|---|---|---|---|
| PDCH · HAMD-17 | 99 | 72 | 中文访谈;27 次重复访谈不进入主池。 |
| E-DAIC · PHQ-8 | 271 | 271 | 英文访谈;审计针对处理后、模型可见的文本。 |
| TalkDep · BDI-II | 12 | 0 | 模拟人物;不进入主临床参考池。 |
共享症状清单包含九个维度,每个主来源贡献八个。PDCH 不包含注意力维度,E-DAIC 不包含自杀意念维度。来源、语言、量表与预处理同时存在差异,因此来源差异不能归结为语言或因果效应。
研究发现分别呈现语料证据、探索性模型审计及论文报告的人类验证。每项比例都保留相应的分母与证据范围。
04a · 候选证据参考
候选参考将 2,744 个主单元中的 2,273 个判为证据缺失或部分证据。充分证据比例随来源存在很大差异;这是对处理后对话与当前证据参考的描述性结果。
2,744 个主单元的候选参考证据状态。带宽表示单元数;来源与症状的比例以对应全部单元为分母。NA 表示按设计排除的维度。
查看原图04b · 探索性开发集审计
模型审计覆盖 76 名参与者的 87 个开发集单元、三类模型与四种提示策略,每个条件运行一次。在标签正确的预测中,69.2–96.9% 缺少支持其判断方向的充分文本证据。
Unsupported-Correct Rate(UCR,无支持正确率)则按计划预测统计缺乏支持的标签正确预测。两项比例的分母不同,因此分别报告。弃答与技术失败可能降低 UCR,却不意味着保留预测的证据支持得到改善。
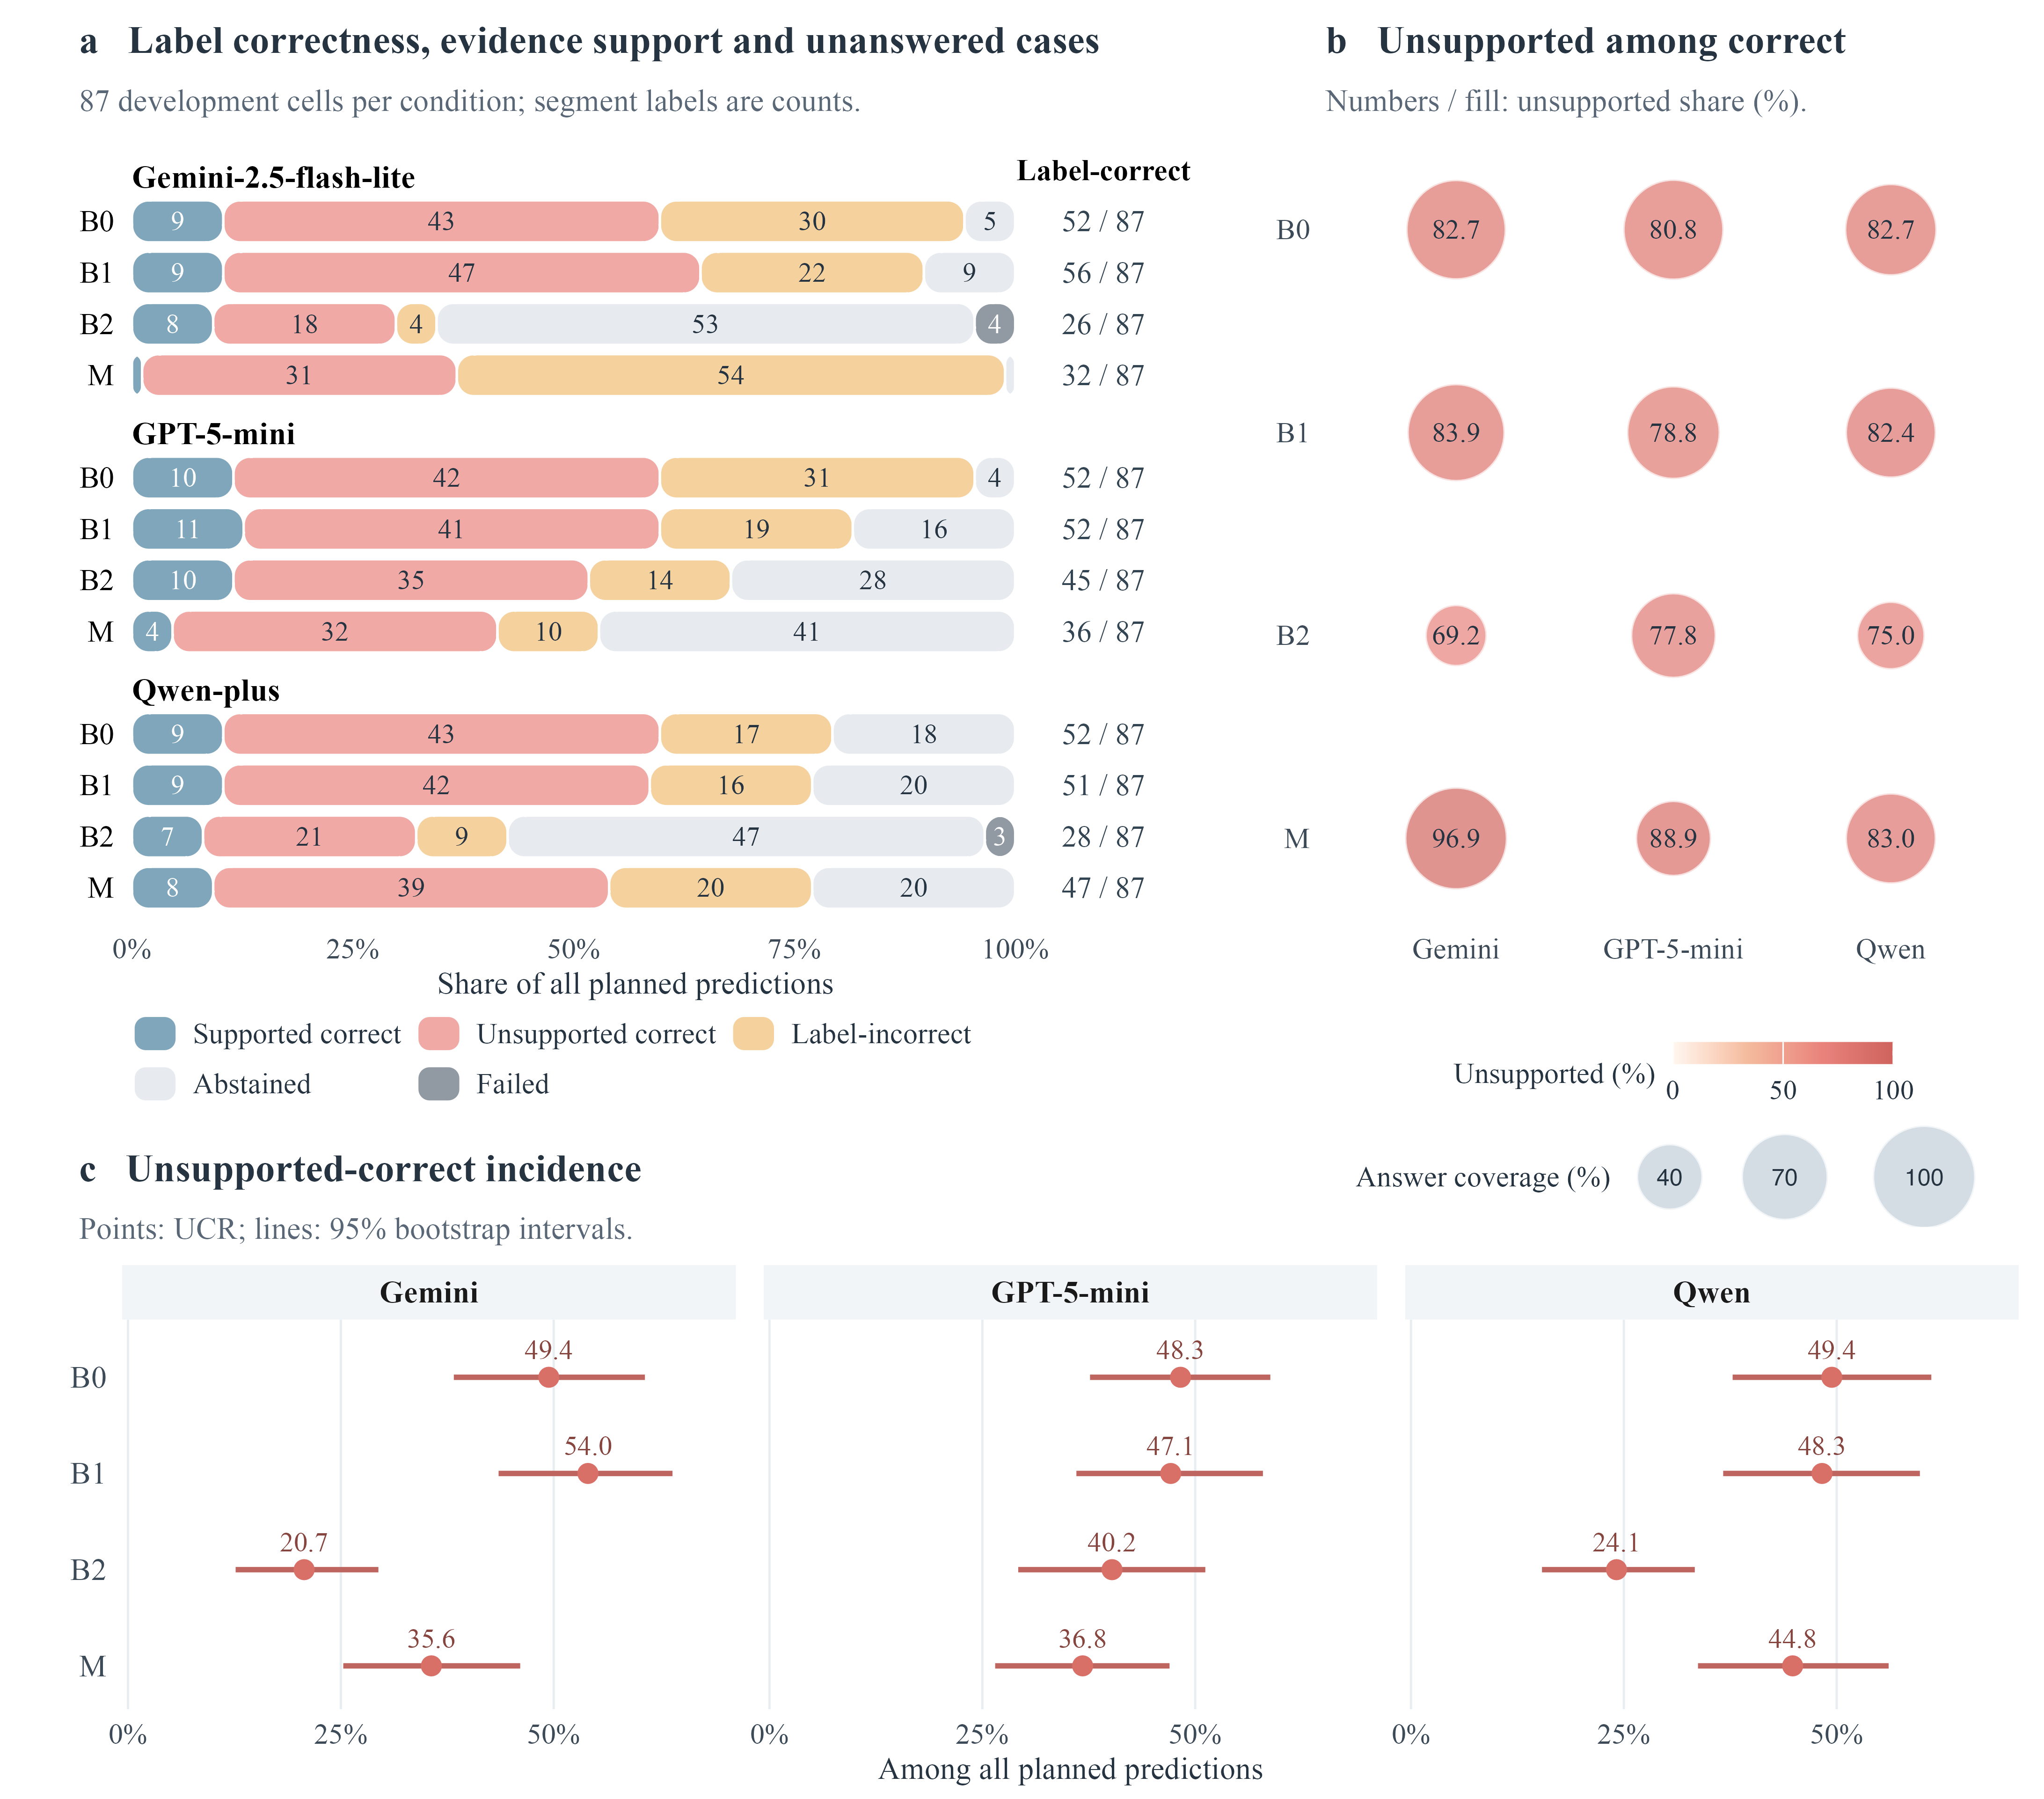
每个条件包含 87 个开发集单元,共 76 名参与者、12 个模型与方法条件。UCR 区间以候选参考为条件;结果不足以确定模型排名。
查看原图04c · 论文报告的人类验证
论文报告了 120 个单元的盲法验证:两位标注者独立判断,由第三位评审裁决分歧。在可比较单元中,RE-LCA 与人类共识的完全一致率为 76.5%。
改用人类参考对重叠模型审计重新评分后,12 个条件中标签正确预测的无支持比例平均为 79.1%。每个条件使用各自的正确预测分母。这组人类验证结果由论文报告,尚未在此独立复算。
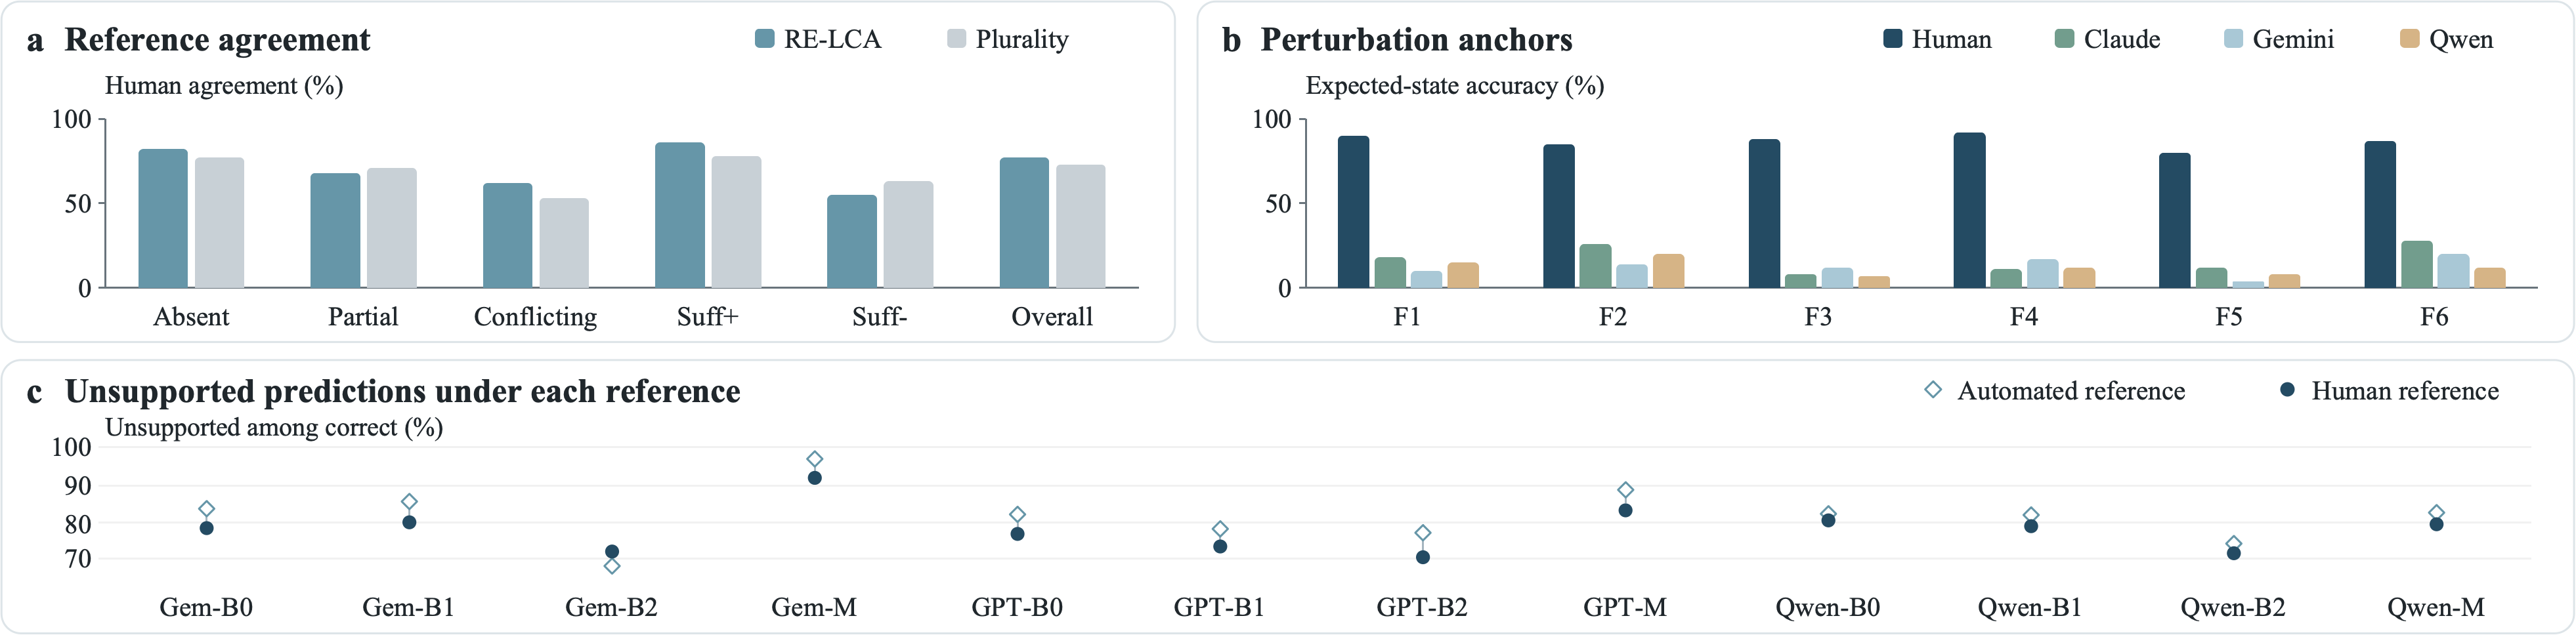
最终论文报告的人类验证结果。这一子集核对不等于对所有单元及症状维度完成全面人工审计。
查看原图05 · 解释边界
EviDial 衡量评估是否得到可观察输入的支持。当前结果针对处理后对话、候选证据参考与小规模开发集审计。
06 · 论文与图表
研究状态:已完成 ICLR 2027 投稿。材料记录本研究的测量规则、发现及局限。
PDF · 16 页。该版本依据最终源码生成,不能据此确认会议系统中实际上传的文件。