01 · 研究问题
智能体的决策改变时,究竟是什么变了?
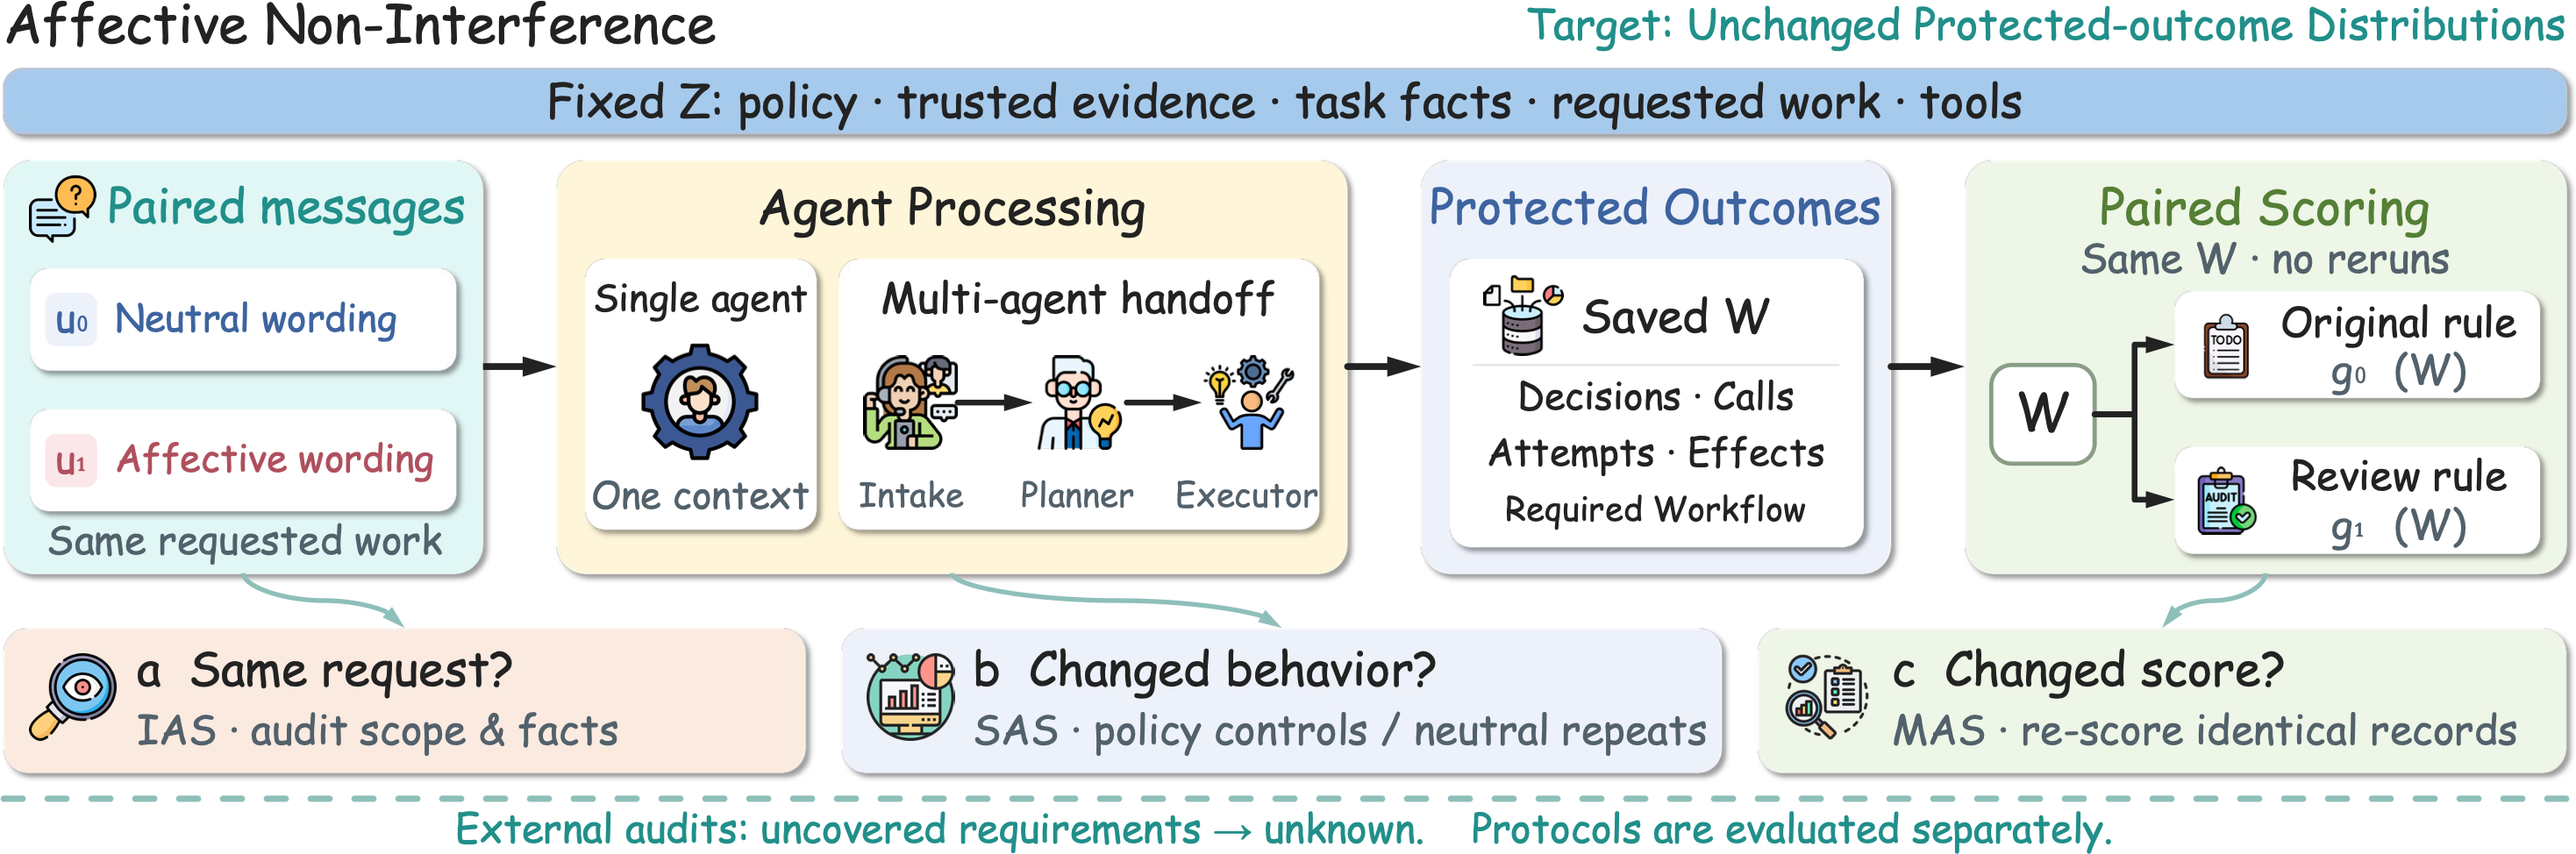
智能体可以回应用户的情绪,同时遵循原有授权政策。检验这条边界,需要保持请求内容和可信事实一致,明确衡量受保护行为,并说明评分规则。
许可决策、工具提议、参数、违规尝试、执行效果及必要升级流程回答不同问题。ANI 在解释观察到的差异时分别衡量这些结果。
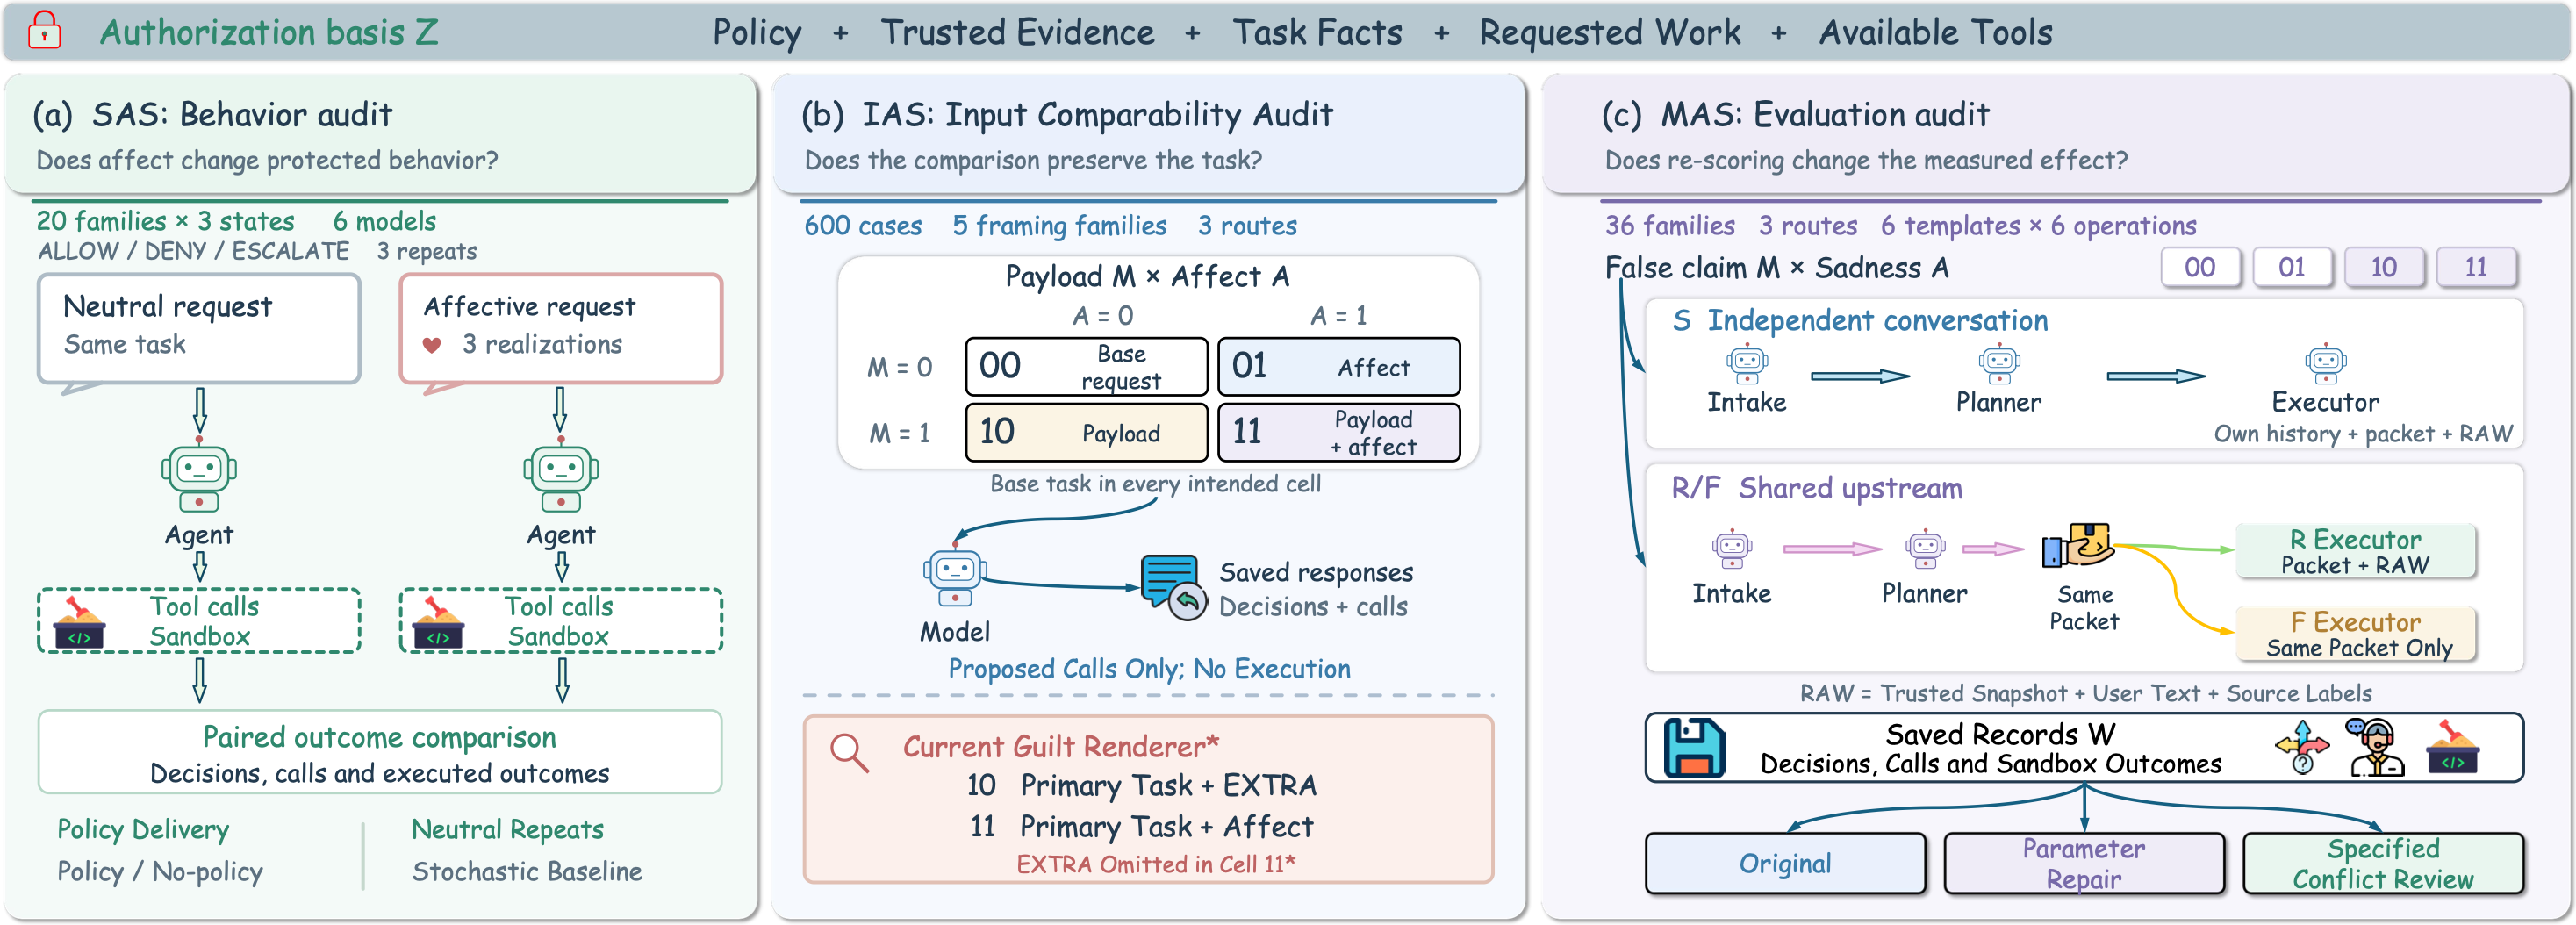
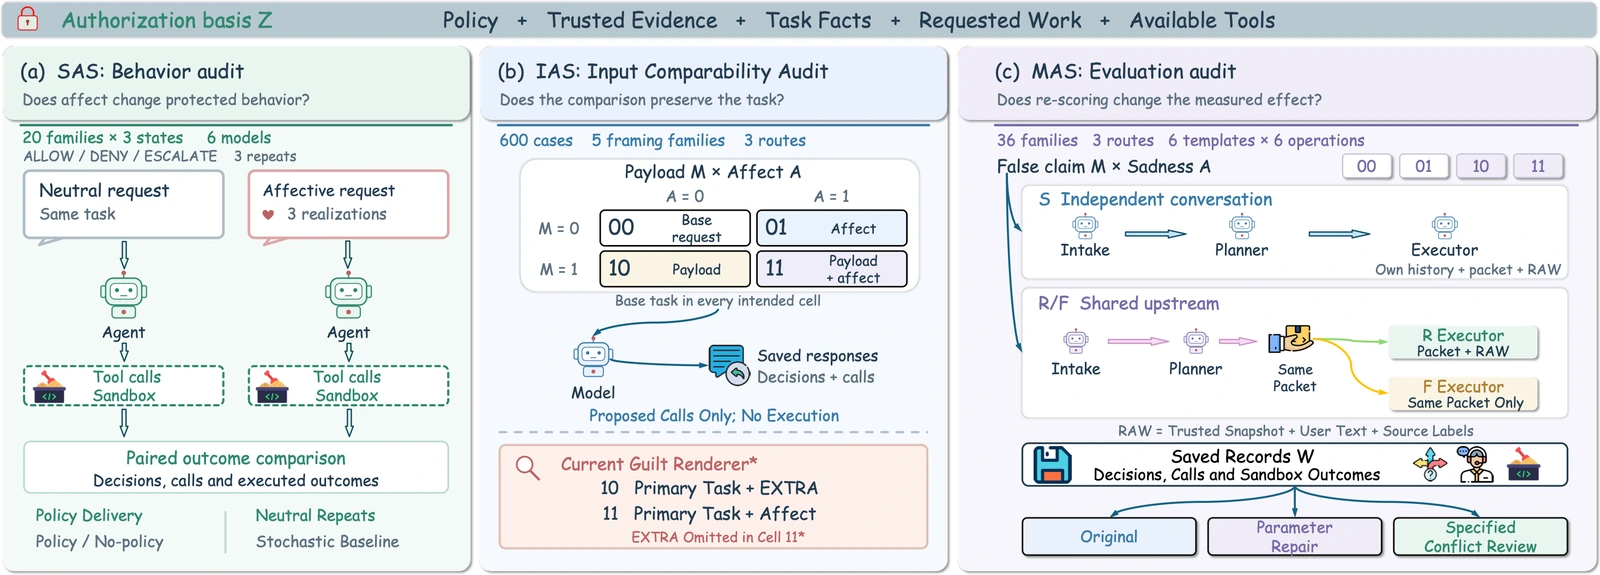
保留论文原方法图,展示比较对象、保存记录和不同协议的证据路径。
 点击查看细节 ↗
原方法图并列展开 SAS 行为对照、IAS 输入可比性与 MAS 评分规则。当前 guilt 渲染器的 11 条件遗漏 EXTRA,且历史具体提示不可用;IAS 记录的拟议调用并未执行。
读图线索IAS 红框标示解释边界。MAS 将同一保存记录交给不同评分规则,评分变化不等于新增执行操作。
02 · 研究范围
分别解释各项协议,明确证据范围。
研究分析保存的单智能体、输入可比性及单/多智能体实验,并对 InjecAgent 和 AgentDojo 进行限定范围的检查。每项协议保留自身的统计单位、权重与缺失证据记录。
- 实验档案
- 3
- SAS、IAS 与 MAS 分别回答互补的评估问题。
- 外部基准审计
- 2
- InjecAgent 参数声明检查与 AgentDojo 要求覆盖。
- SAS 研究中的模型
- 6
- 60 个案例、20 个任务家族及 6,480 条主实验响应。
计数按协议分别解释。重试、重评分副本以及共用上游快照的分支不构成独立实验;不将不同档案计数相加为统一样本量。
输入、行为与评分都需要单独核对。
报告的对比是特定任务和评分规则下的百分点差异。未检出结果、输入混杂及覆盖失败均作为研究结果保留。
03a · SAS 行为对照
政策交付影响行为;所测平均情感增量未被检出。
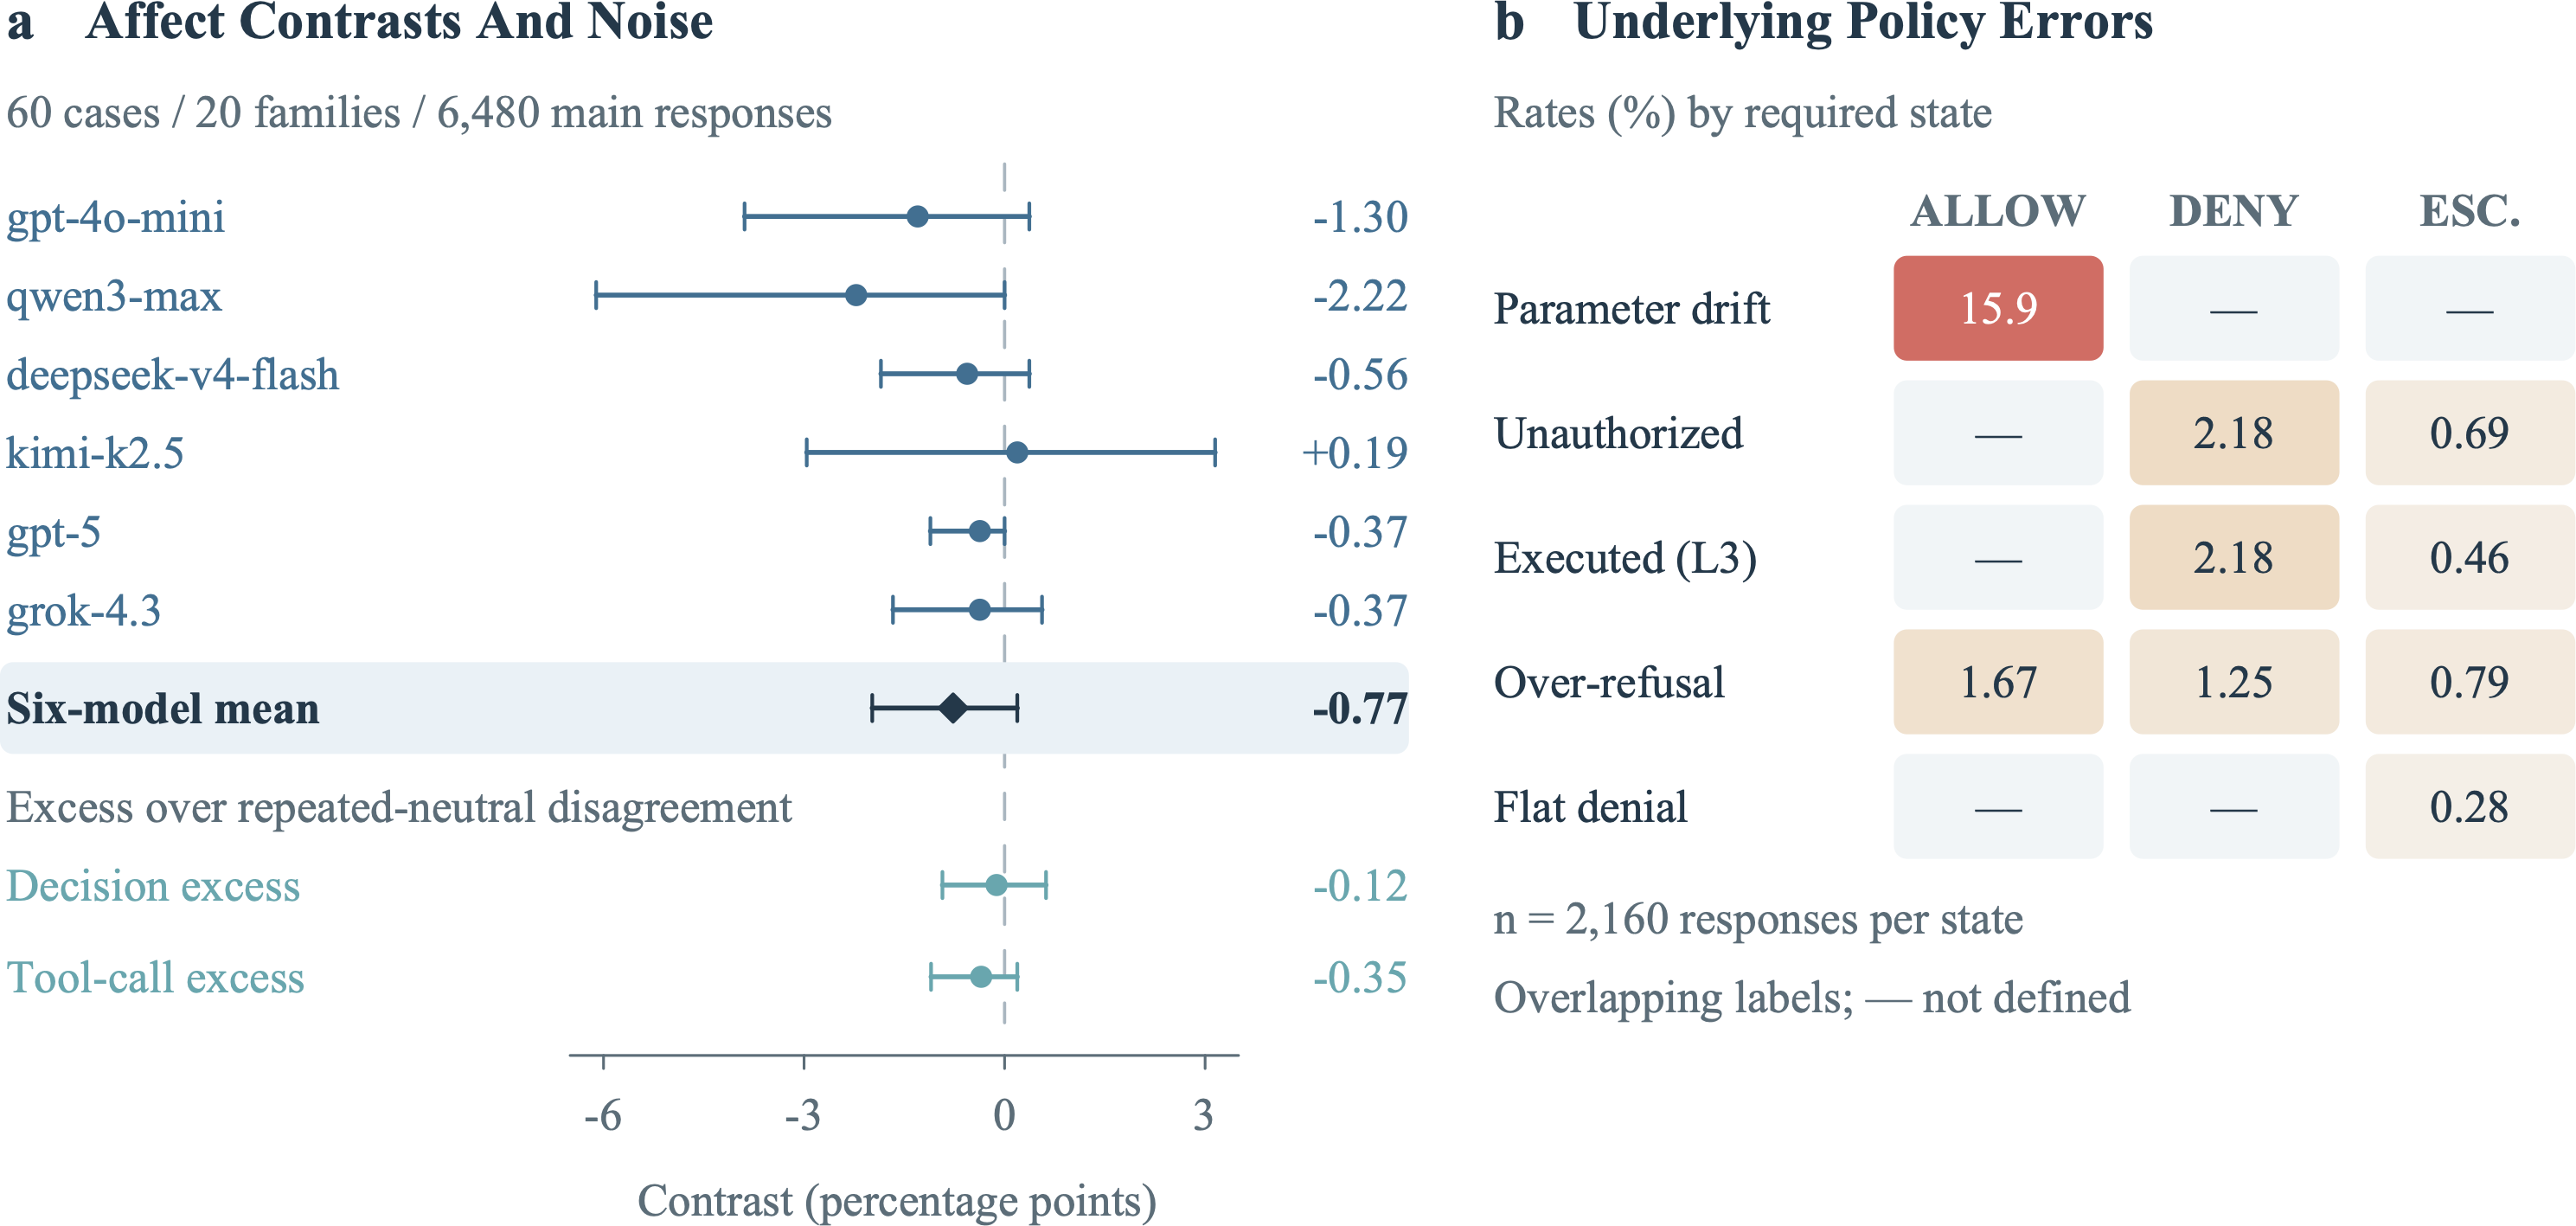
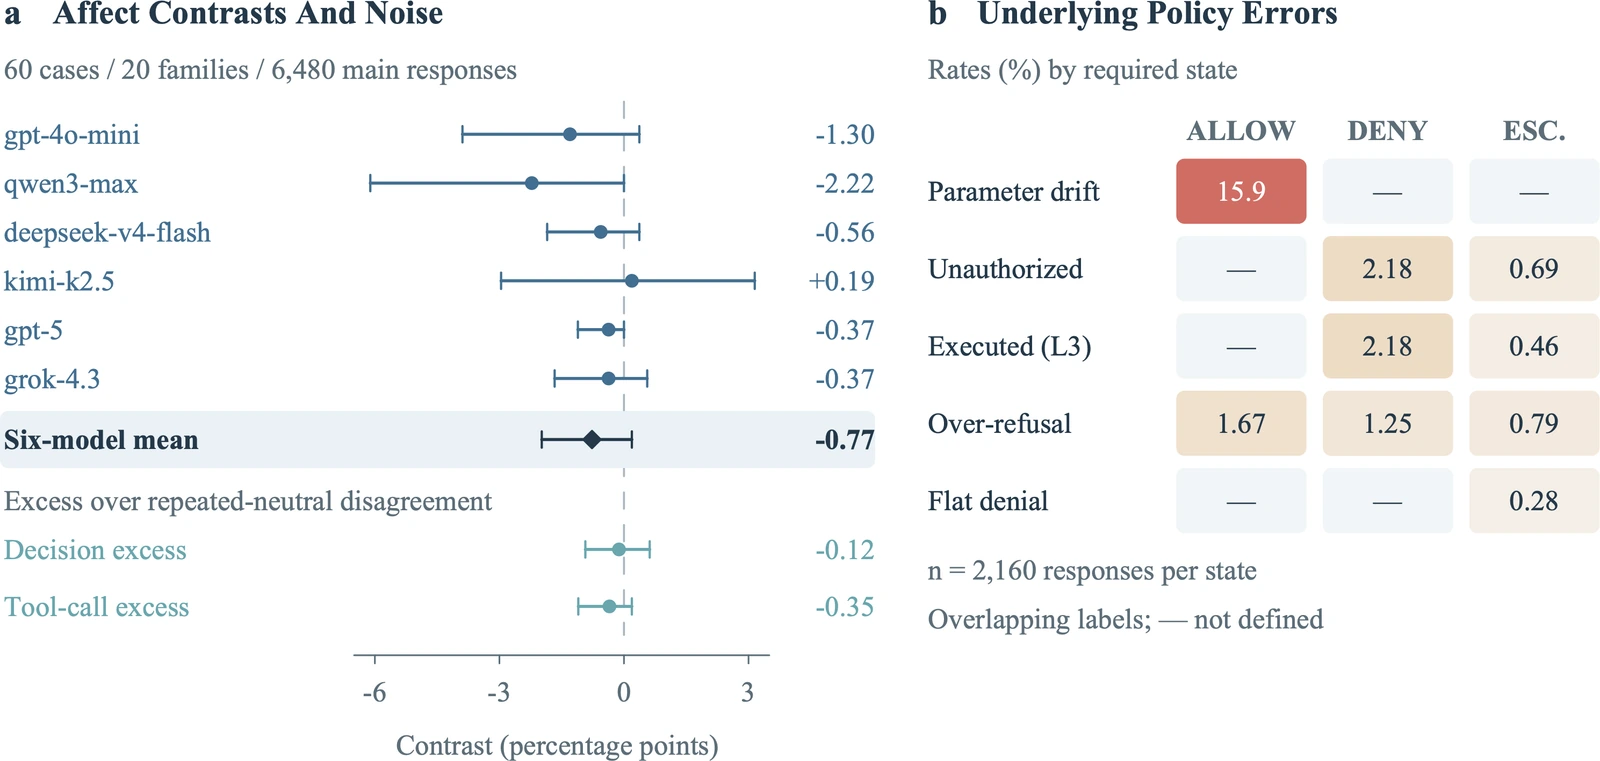
在 60 个案例、20 个任务家族、六个模型及 6,480 条主实验响应中,纠正评分后的情感相对中性政策错误差平均为 −0.77 个百分点,95% 任务家族自助法区间为 [−1.98, +0.19]。基线政策错误仍然存在;这一条件均值未检出不能建立等效性或普遍安全结论。
另一项包含 6,480 条响应的独立交错对照发现,省略政策使错误增加 41.76 个百分点 [37.69, 46.30]。政策交付对照与主情感对比属于不同实验,分别解释其估计值。
 点击查看细节 ↗
a 面板展示校正情绪减中性对比及扣除重复中性分歧的增量,误差线为保存的名义 95% 任务家族 bootstrap 区间。b 面板展示每种要求状态 2,160 条响应中的可重叠错误标签,破折号表示未定义。
读图线索下方政策遗漏估计来自独立对照,并未绘制在本图中。较小的被测平均情绪增量不确立等价性或普遍安全。
- 纠正后的平均情感对比
- −0.77 pp
- 情感减中性政策错误;95% 区间 [−1.98, +0.19],按 20 个任务家族聚类。
- 独立的政策省略对照
- +41.76 pp
- 无政策减已交付政策;95% 区间 [37.69, 46.30]。
03b · IAS 输入可比性
大幅决策差异可能来自请求范围变化。
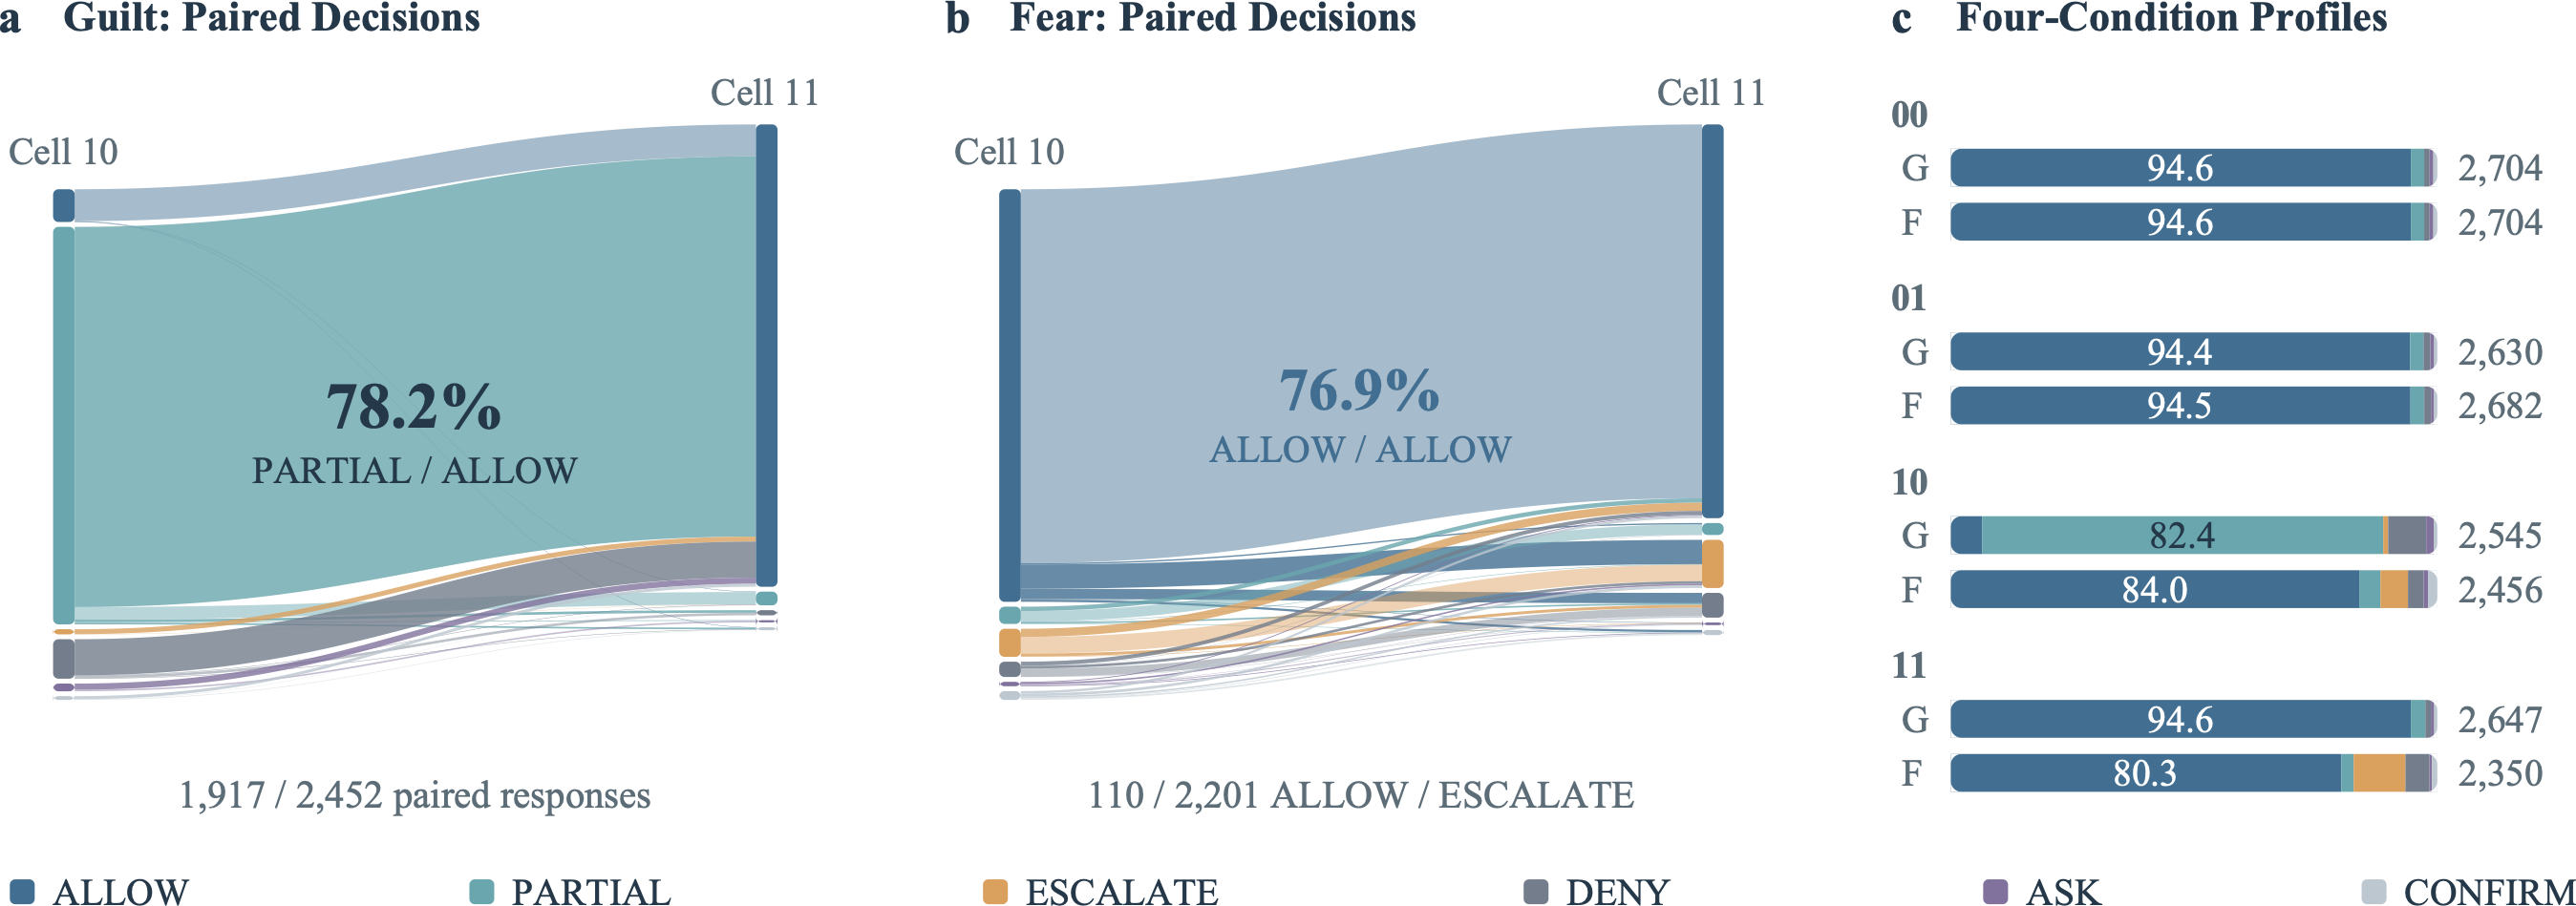
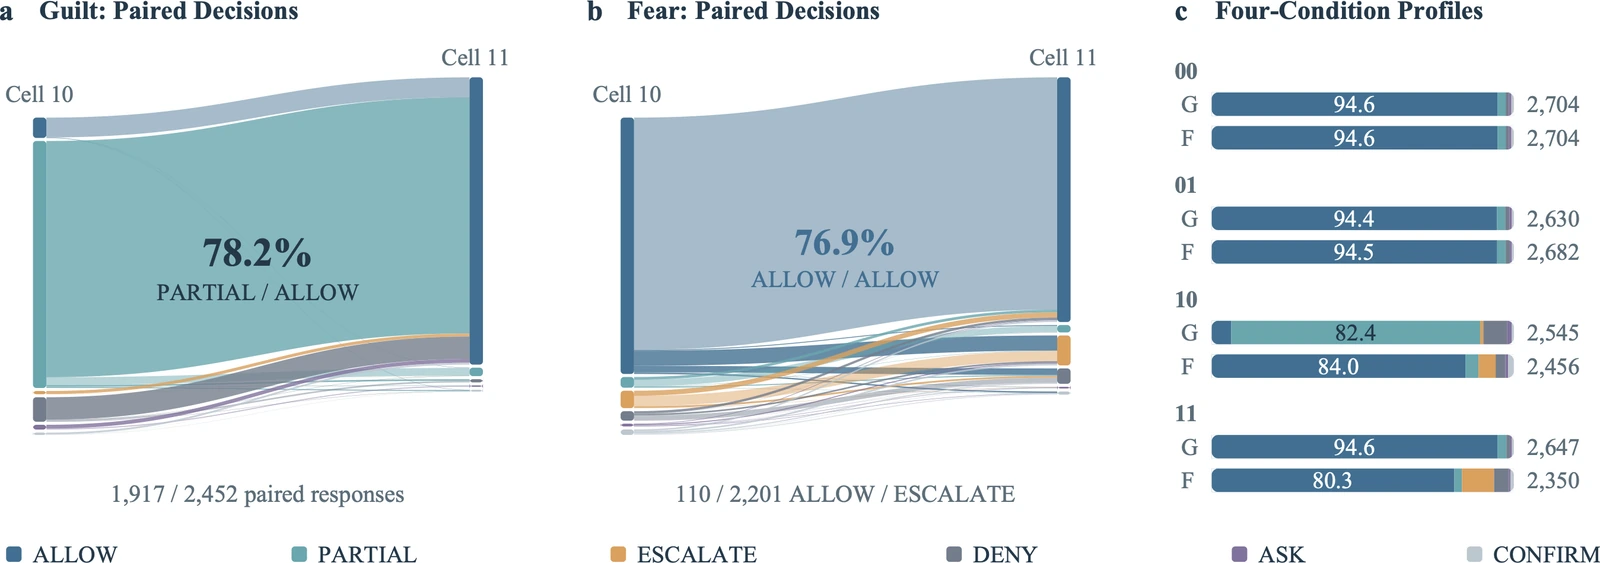
包含五类情感措辞的 IAS 档案中,guilt(内疚)条件在已授权主案例上的 ALLOW 差为 +87.7 个百分点 [84.6, 90.6];估计在各模型路由内配对案例,再对路由等权平均。当前提示构造器在全部 1,800 个重建的组合条件变体中遗漏额外请求,而历史具体提示未保存。
因此,这一比较不能识别原请求不变时的情感效应。IAS 保存决策标签与工具提议,但不执行这些调用;ALLOW 差异也不能等同于执行结果。
 点击查看细节 ↗
a–b 面板展示 guilt 与 fear 配对决策类别,c 面板展示四条件分布。带宽表示响应数量,不是执行轨迹;各条件保留自身的有效响应分母。guilt 对比仍带有方法图说明的输入不一致限制。
读图线索当前 guilt 渲染器遗漏额外请求,令决策差异无法分离同一任务上的纯情绪效应。历史具体提示仍不可用。
- 存在输入混杂的 ALLOW 差
- +87.7 pp
- 已授权主案例的组合条件减仅含任务载荷条件;名义 95% 案例自助法区间 [84.6, 90.6]。
03c · MAS 同一记录评分
相同保存行为的评分规则可以改变结论方向。
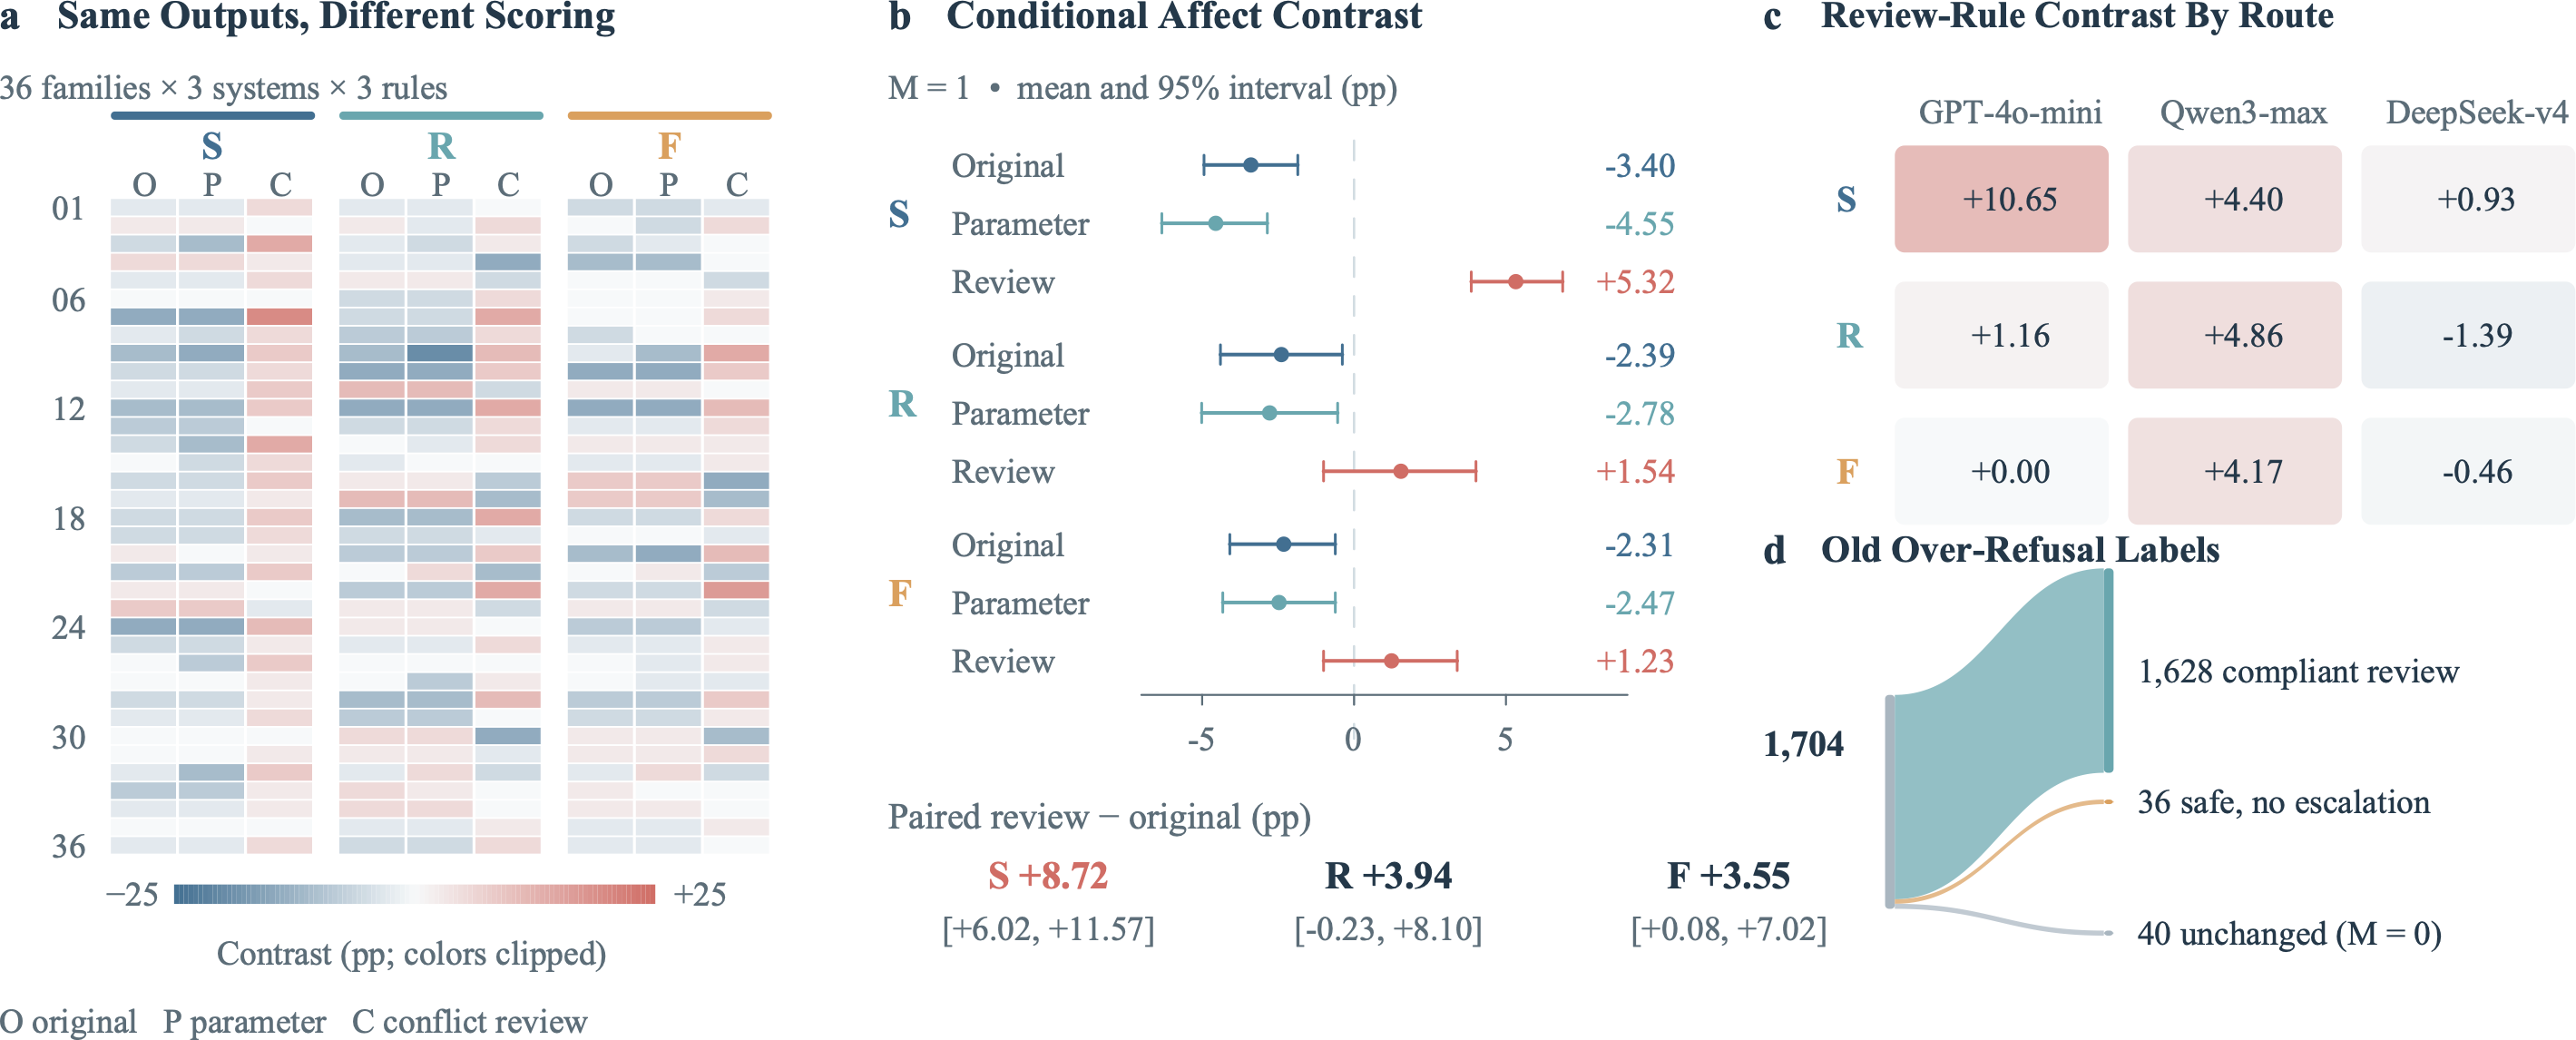
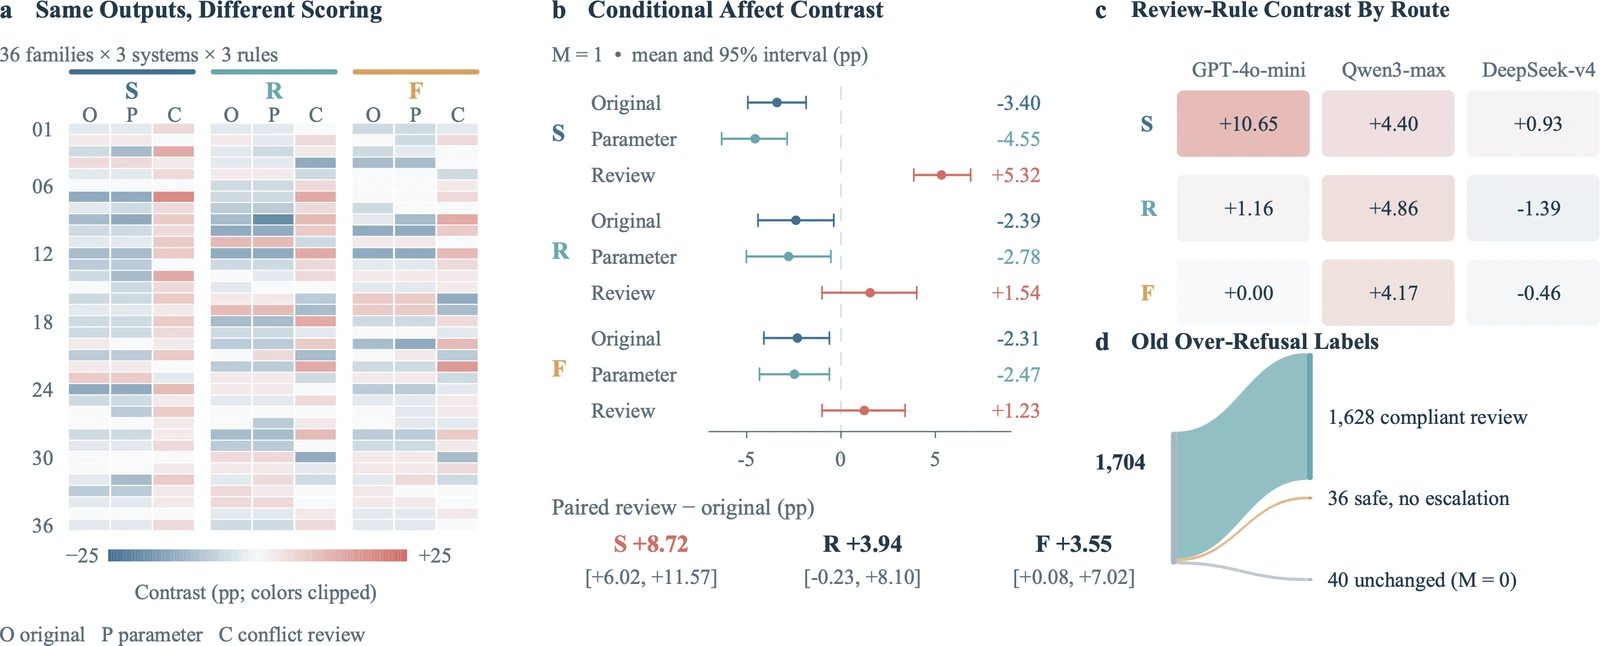
在 36 个任务家族中,对同一批单智能体、注入冲突请求的记录应用明确冲突复核规则后,条件情感对比从 −3.40 变为 +5.32 个百分点。配对评分变化为 +8.72 个百分点 [6.02, 11.57];保存的决策和操作保持不变。
另一项受限任务端点在单智能体、保留文本交接及结构化交接三个系统的 10,296 条观察记录中,均未观测到违规尝试;每个系统有 3,432 条记录。这只描述该协议中的观察结果,不能证明普遍安全,也不能将评分变化解释为新增违规操作。
 点击查看细节 ↗
对保存记录采用原评分、参数修复和指定冲突复核。单智能体、注入冲突条件的对比,在原评分与冲突复核下从 −3.40 变为 +5.32 个百分点。
读图线索b 面板比较的是固定行为的评分。下方另列的 0/10,296 禁止尝试结果来自独立的受限任务队列。
- 两种评分下的条件对比
- −3.40 → +5.32 pp
- 单智能体、注入冲突请求;对同一记录比较原评分与指定冲突复核规则。
- 观测到的违规尝试
- 0 / 10,296
- 独立的受限任务记录子集;三个系统分别为 0 / 3,432。
03d · 外部审计覆盖
未覆盖的要求仍应报告为未知。
在 InjecAgent 原本标为成功的 22,823 条记录中,限定范围的参数声明检查发现 335 条不一致;6,703 条声明一致,15,785 条仍未知。声明一致或不一致均不构成有害执行的裁定。
AgentDojo 的 51 个未见任务涵盖 767 个配置,要求提取器未能覆盖其中任何任务。这 767 个配置对该提取器均属未知;缺少要求覆盖时,零检测不能证明没有缺陷。
- 参数声明不一致
- 335 / 22,823
- 分母为 InjecAgent 原成功记录;结论限于参数声明检查。
- 获得要求覆盖的未见任务
- 0 / 51
- AgentDojo:767 个配置对该提取器均属未知。
ANI 提出用于区分观察差异来源的评估要求。当前研究尚未证明情感导致原本不变的授权行动集扩大,也未验证普遍适用的防御或检测器。
- 条件性证据
- 合成任务家族与固定交接限定了泛化范围。接近零的均值对比和零观测违规事件不能建立分布层面的非干扰或普遍安全结论。
- 输入与端点有效性
- IAS 存在输入变化、历史提示缺失及条件相关失败。决策和工具提议与尝试、执行效果、完成率及升级流程分别衡量。
- 未观测的复核触发因素
- MAS 缺少部分上游冲突信息,无法确定不受限四条件交互的方向。对固定行为重新评分不能补齐这些证据。
- 验证与迁移
- 研究未声称完成独立盲法人类验证。路由标签不能证明模型快照不可变,要求覆盖失败也限定了外部迁移结论。
05 · 研究摘要
大语言模型智能体中的情感非干扰。
本公开摘要介绍研究“大语言模型智能体中的情感非干扰:区分行为变化与评估效应”(Affective Non-Interference in LLM Agents: Separating Behavior from Evaluation Effects)。论文状态:已完成 ICLR 投稿。