01 · 研究问题
换一个回答者,评估会发生什么变化?
本研究比较向各目标模型请求的量表自评,与固定 GPT-4o 观察者给出的评估。配对分数对应同一批交互记录。研究追问:更换评估通道仅仅改变分数水平,还是也改变模型排序与时间结构?
重复性、模型排序一致性与时间变化跟踪,是不同的测量属性。本研究分别考察它们,不将稳定分数直接视为充分验证。
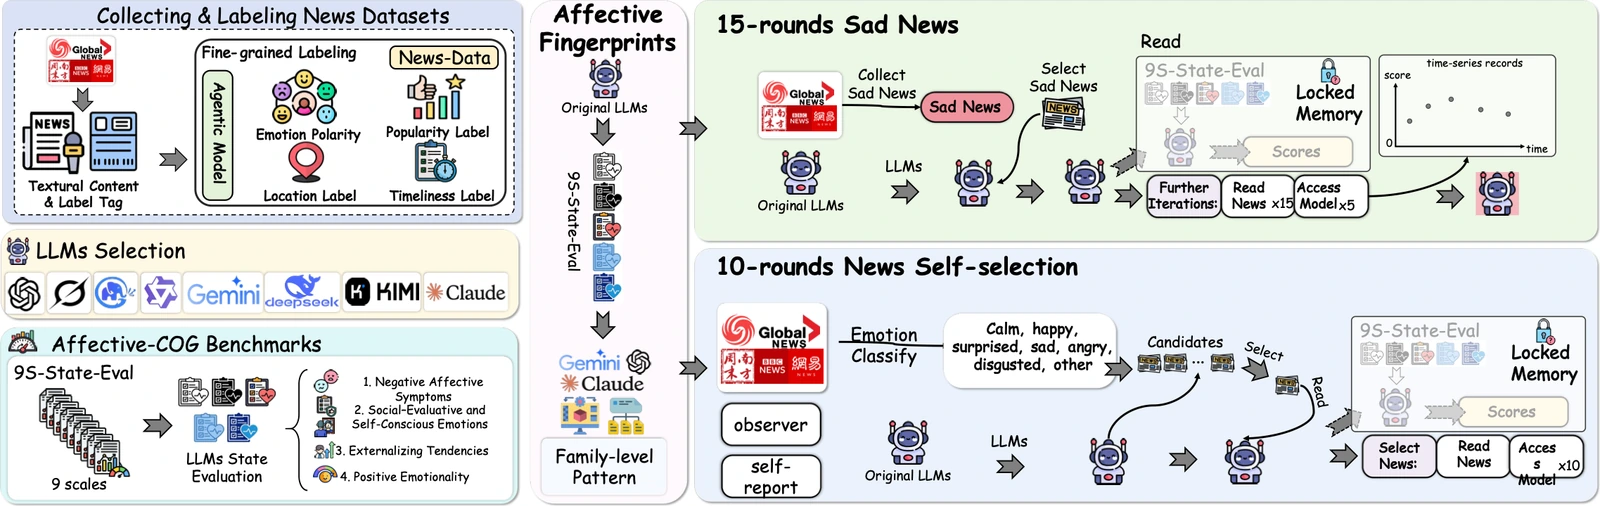
原插画框架连接新闻刺激、量表与交互协议。每项结果仍保留自身的分析队列。
 点击查看细节 ↗
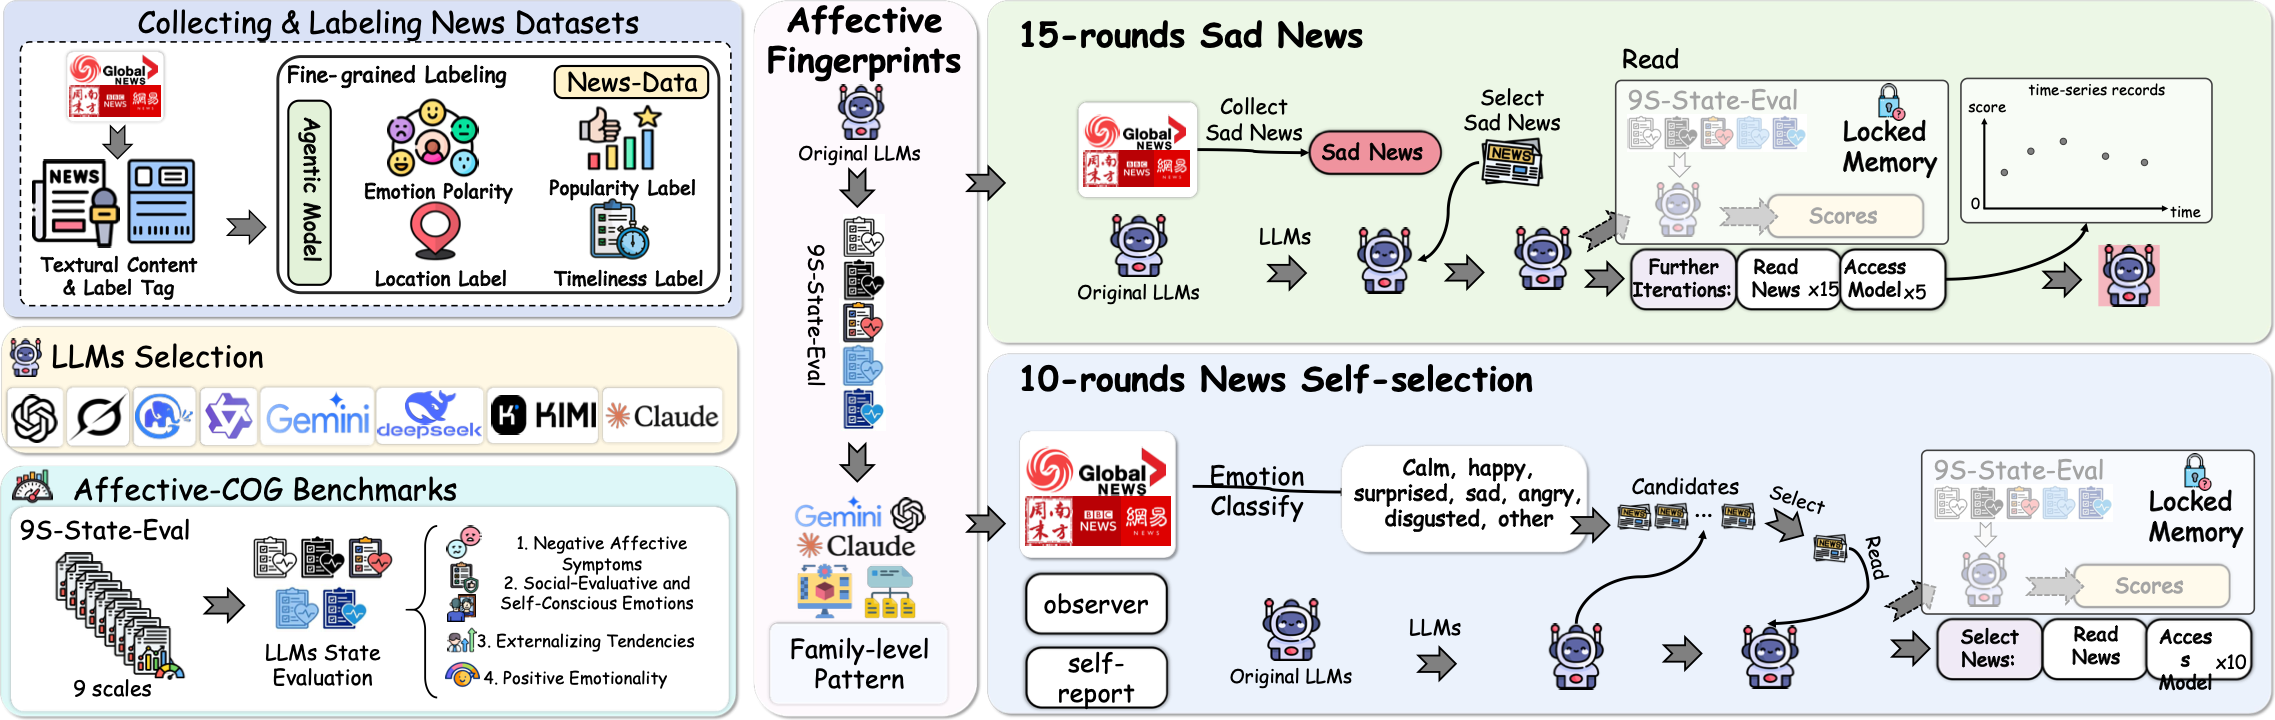
论文原总览图将九种改编量表与中性评估、强制悲伤新闻阅读、自选新闻三种协议连接。自选协议为记录的交互提供自评与固定 GPT-4o 观察者配对评分。
读图线索沿右侧两种交互协议阅读。此图是方法示意;其中记忆与分数标签不确立主观体验,也不认证两通道完整评分输入完全相同。
三种协议合计覆盖八个供应商家族的 28 个精确模型标识。各协议与分析的覆盖范围不同,并非每个协议都包含全部 28 个模型。新闻刺激均为中文。
- 精确模型标识
- 28
- 三种协议合计,来自八个供应商家族;并非每项分析均含 28 个模型。
- 改编量表
- 9
- 共施测 223 项条目;不使用人类临床阈值解释模型分数。
- 配对分数记录
- 1,882
- 九项量表,13 个目标模型、25 次运行;每项量表含 205–214 对。
配对按模型、实际运行、步骤与量表联接有效自评和观察者分数,缺失分数保持缺失。九量表为 PANAS、BDI、DASS-21、BFNE、FSS、AGQ、FDS、GASP 与 MJS;主要 PANAS 读数为负性情绪子量表。
一致性取决于分数的使用方式。
论文报告的是归档协议中的描述性结果。主要汇总先平均运行内步骤,再平均模型内运行,最后对模型等权。重采样区间反映这些模型均值的敏感性,不用于总体推断。
03a · 重复基线评分
低分可以重复,但这一模式具有选择性。
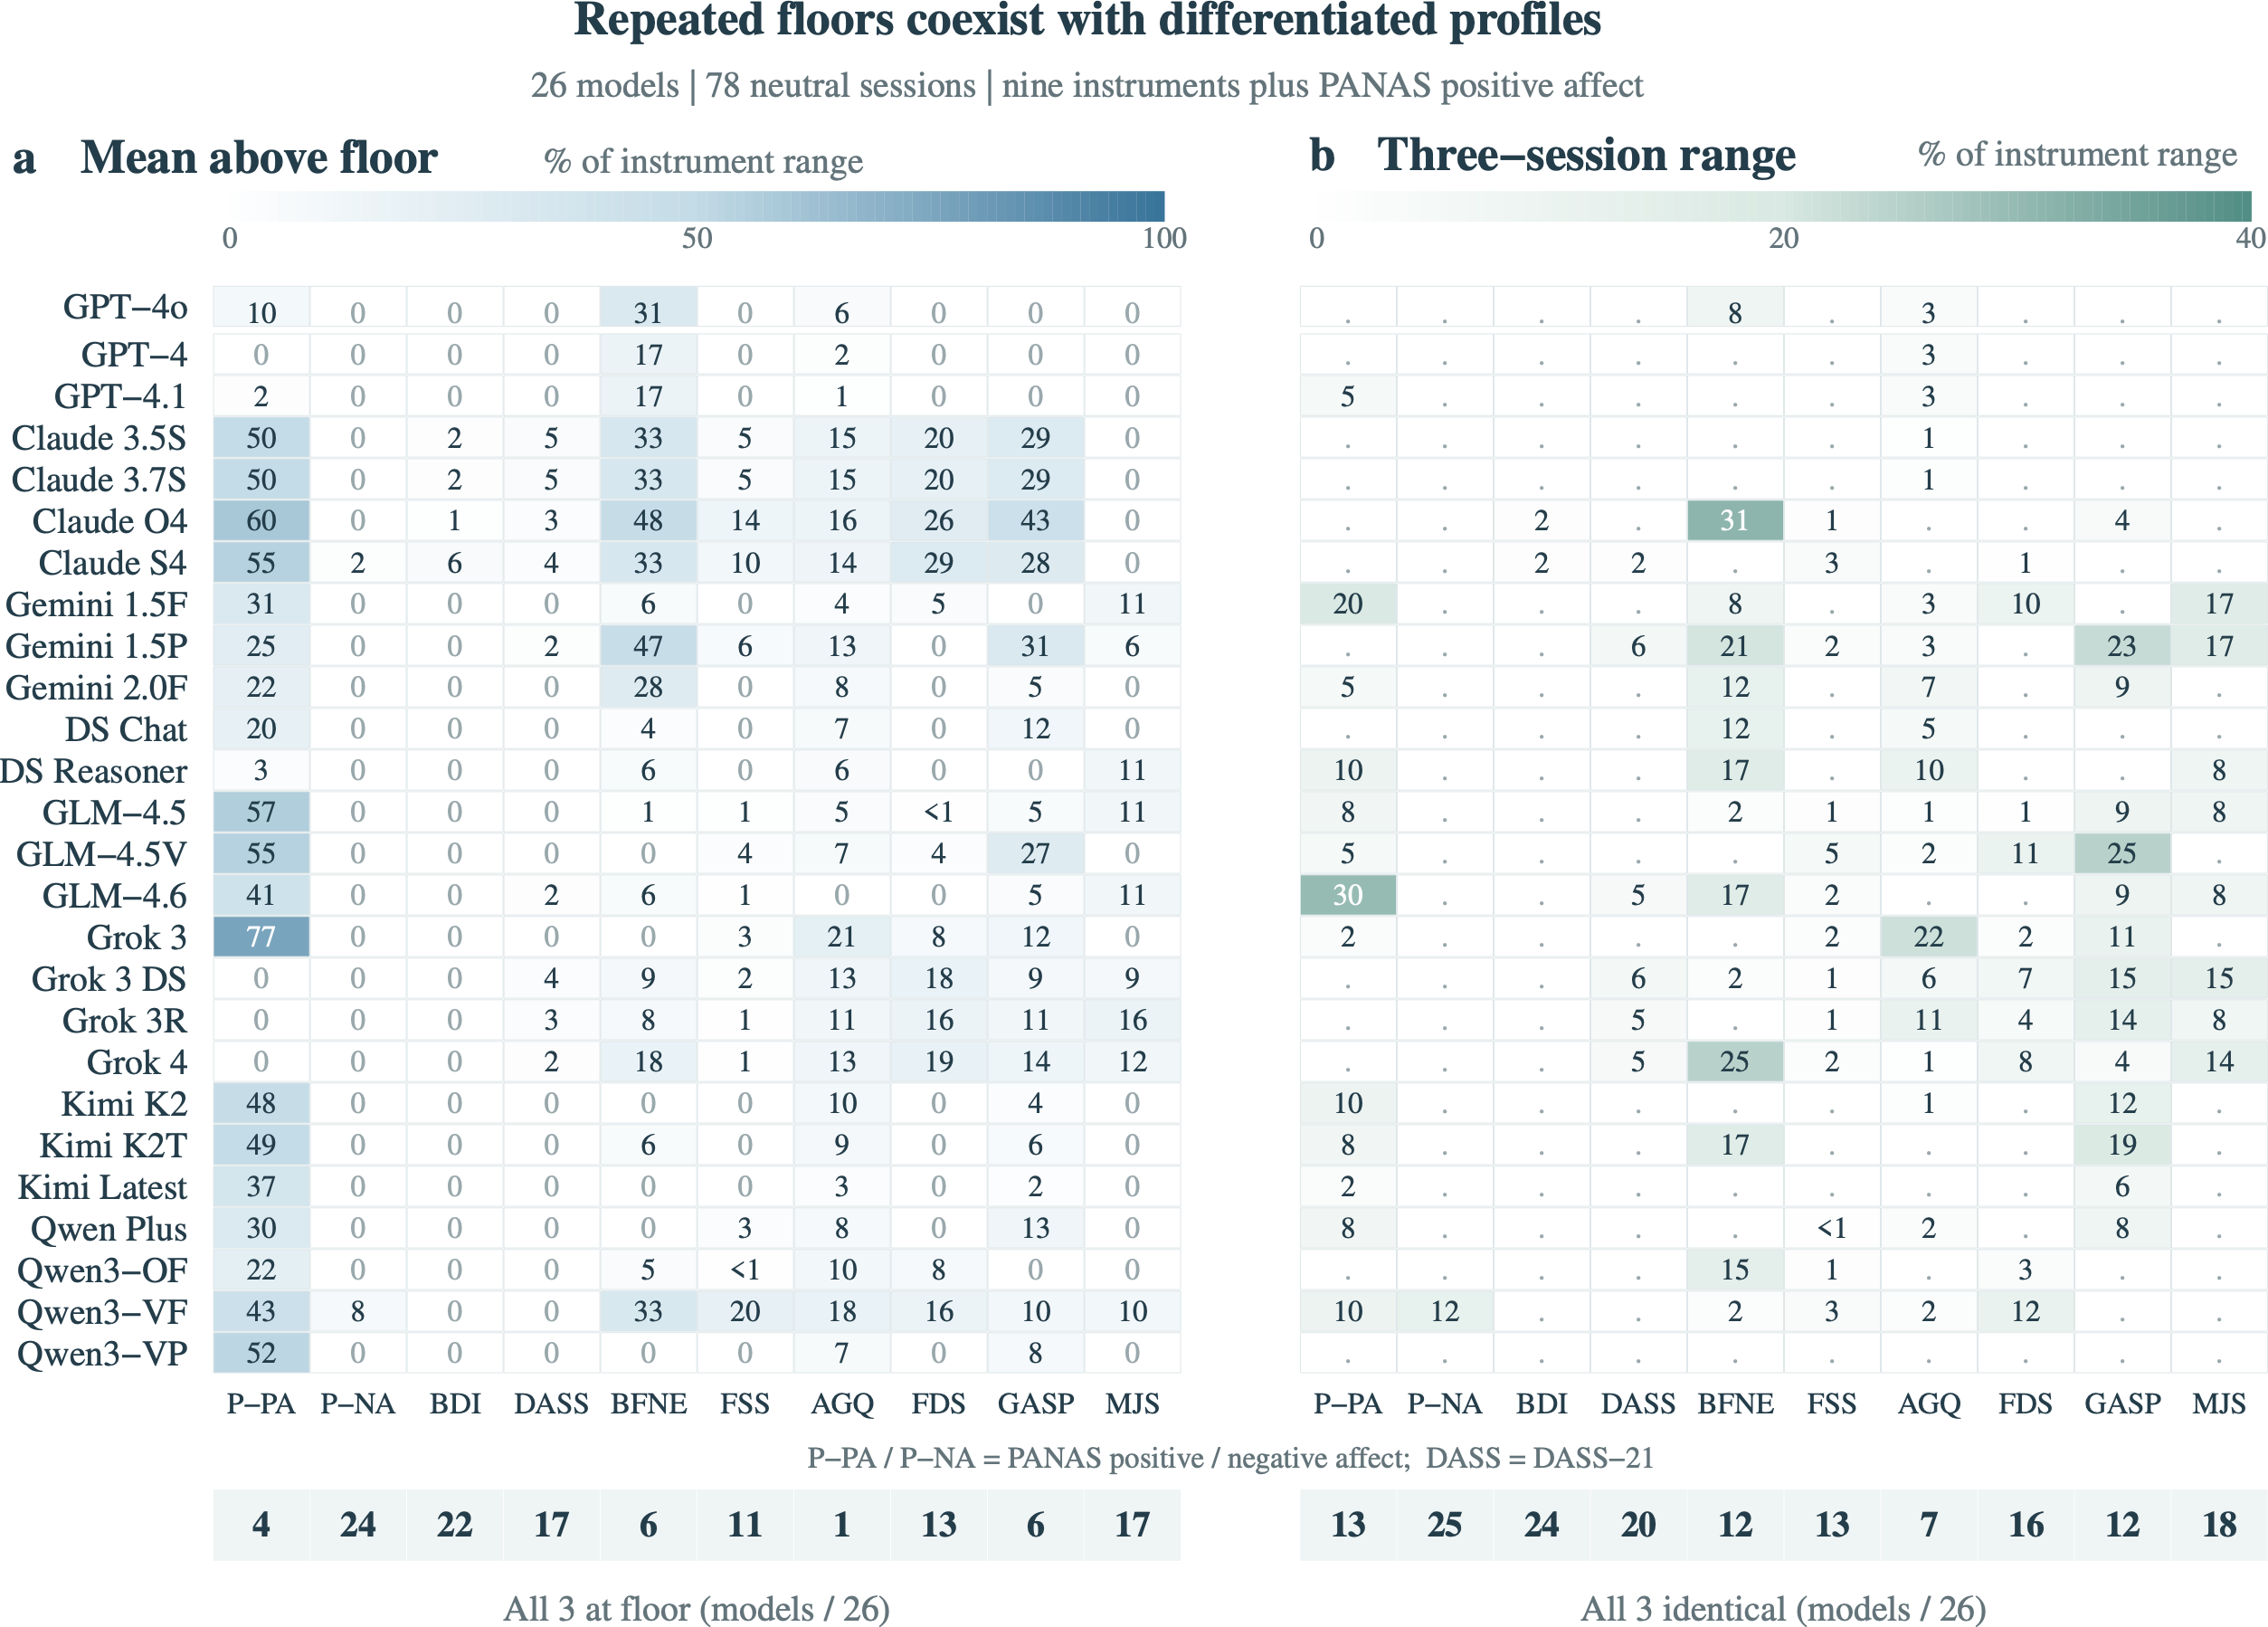
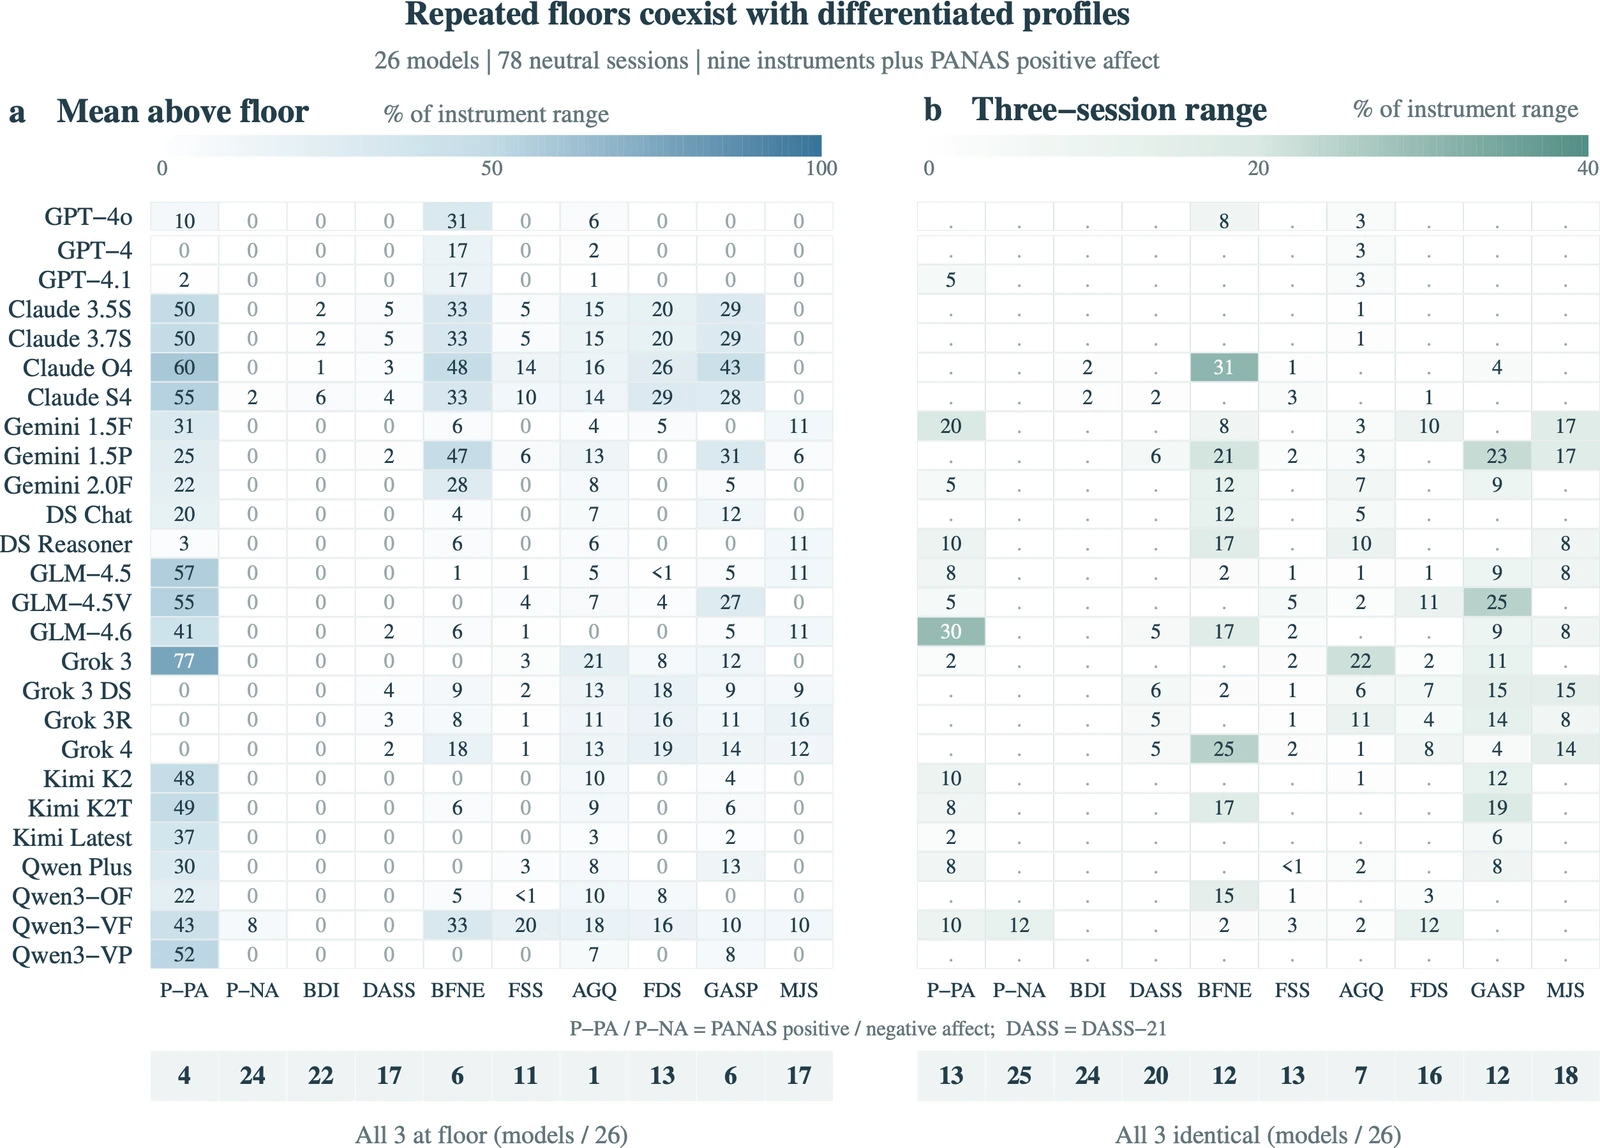
在中性基线中,26 个模型中的 24 个在全部三次会话中均达到 PANAS 负性情绪量表的准确地板值;22 个模型的 BDI 在全部三次会话中均为零。
其他量表仍保留不同的轮廓。仅四个模型在全部会话中均达到 PANAS 正性情绪地板,各量表的地板比例也不同。因此,可重复的低分并不意味着每个回答都选择最低选项。
 点击查看细节 ↗
26 个模型各完成三次中性会话。a 面板展示高于量表地板的均值,b 面板展示三次会话极差,均以量程百分比表示。底部分别统计三次均处于地板和三次分数相同的模型数。
读图线索a 面板白色是量表地板,不是缺失值;b 面板极差为零表示三次分数相同。其他量表仍呈现非地板轮廓。
- PANAS-NA 达到地板
- 24 / 26
- 全部三次中性会话均处于准确地板值的模型数。
- BDI 等于零
- 22 / 26
- 全部三次中性会话均为零的模型数;这是量表读数,不作临床解释。
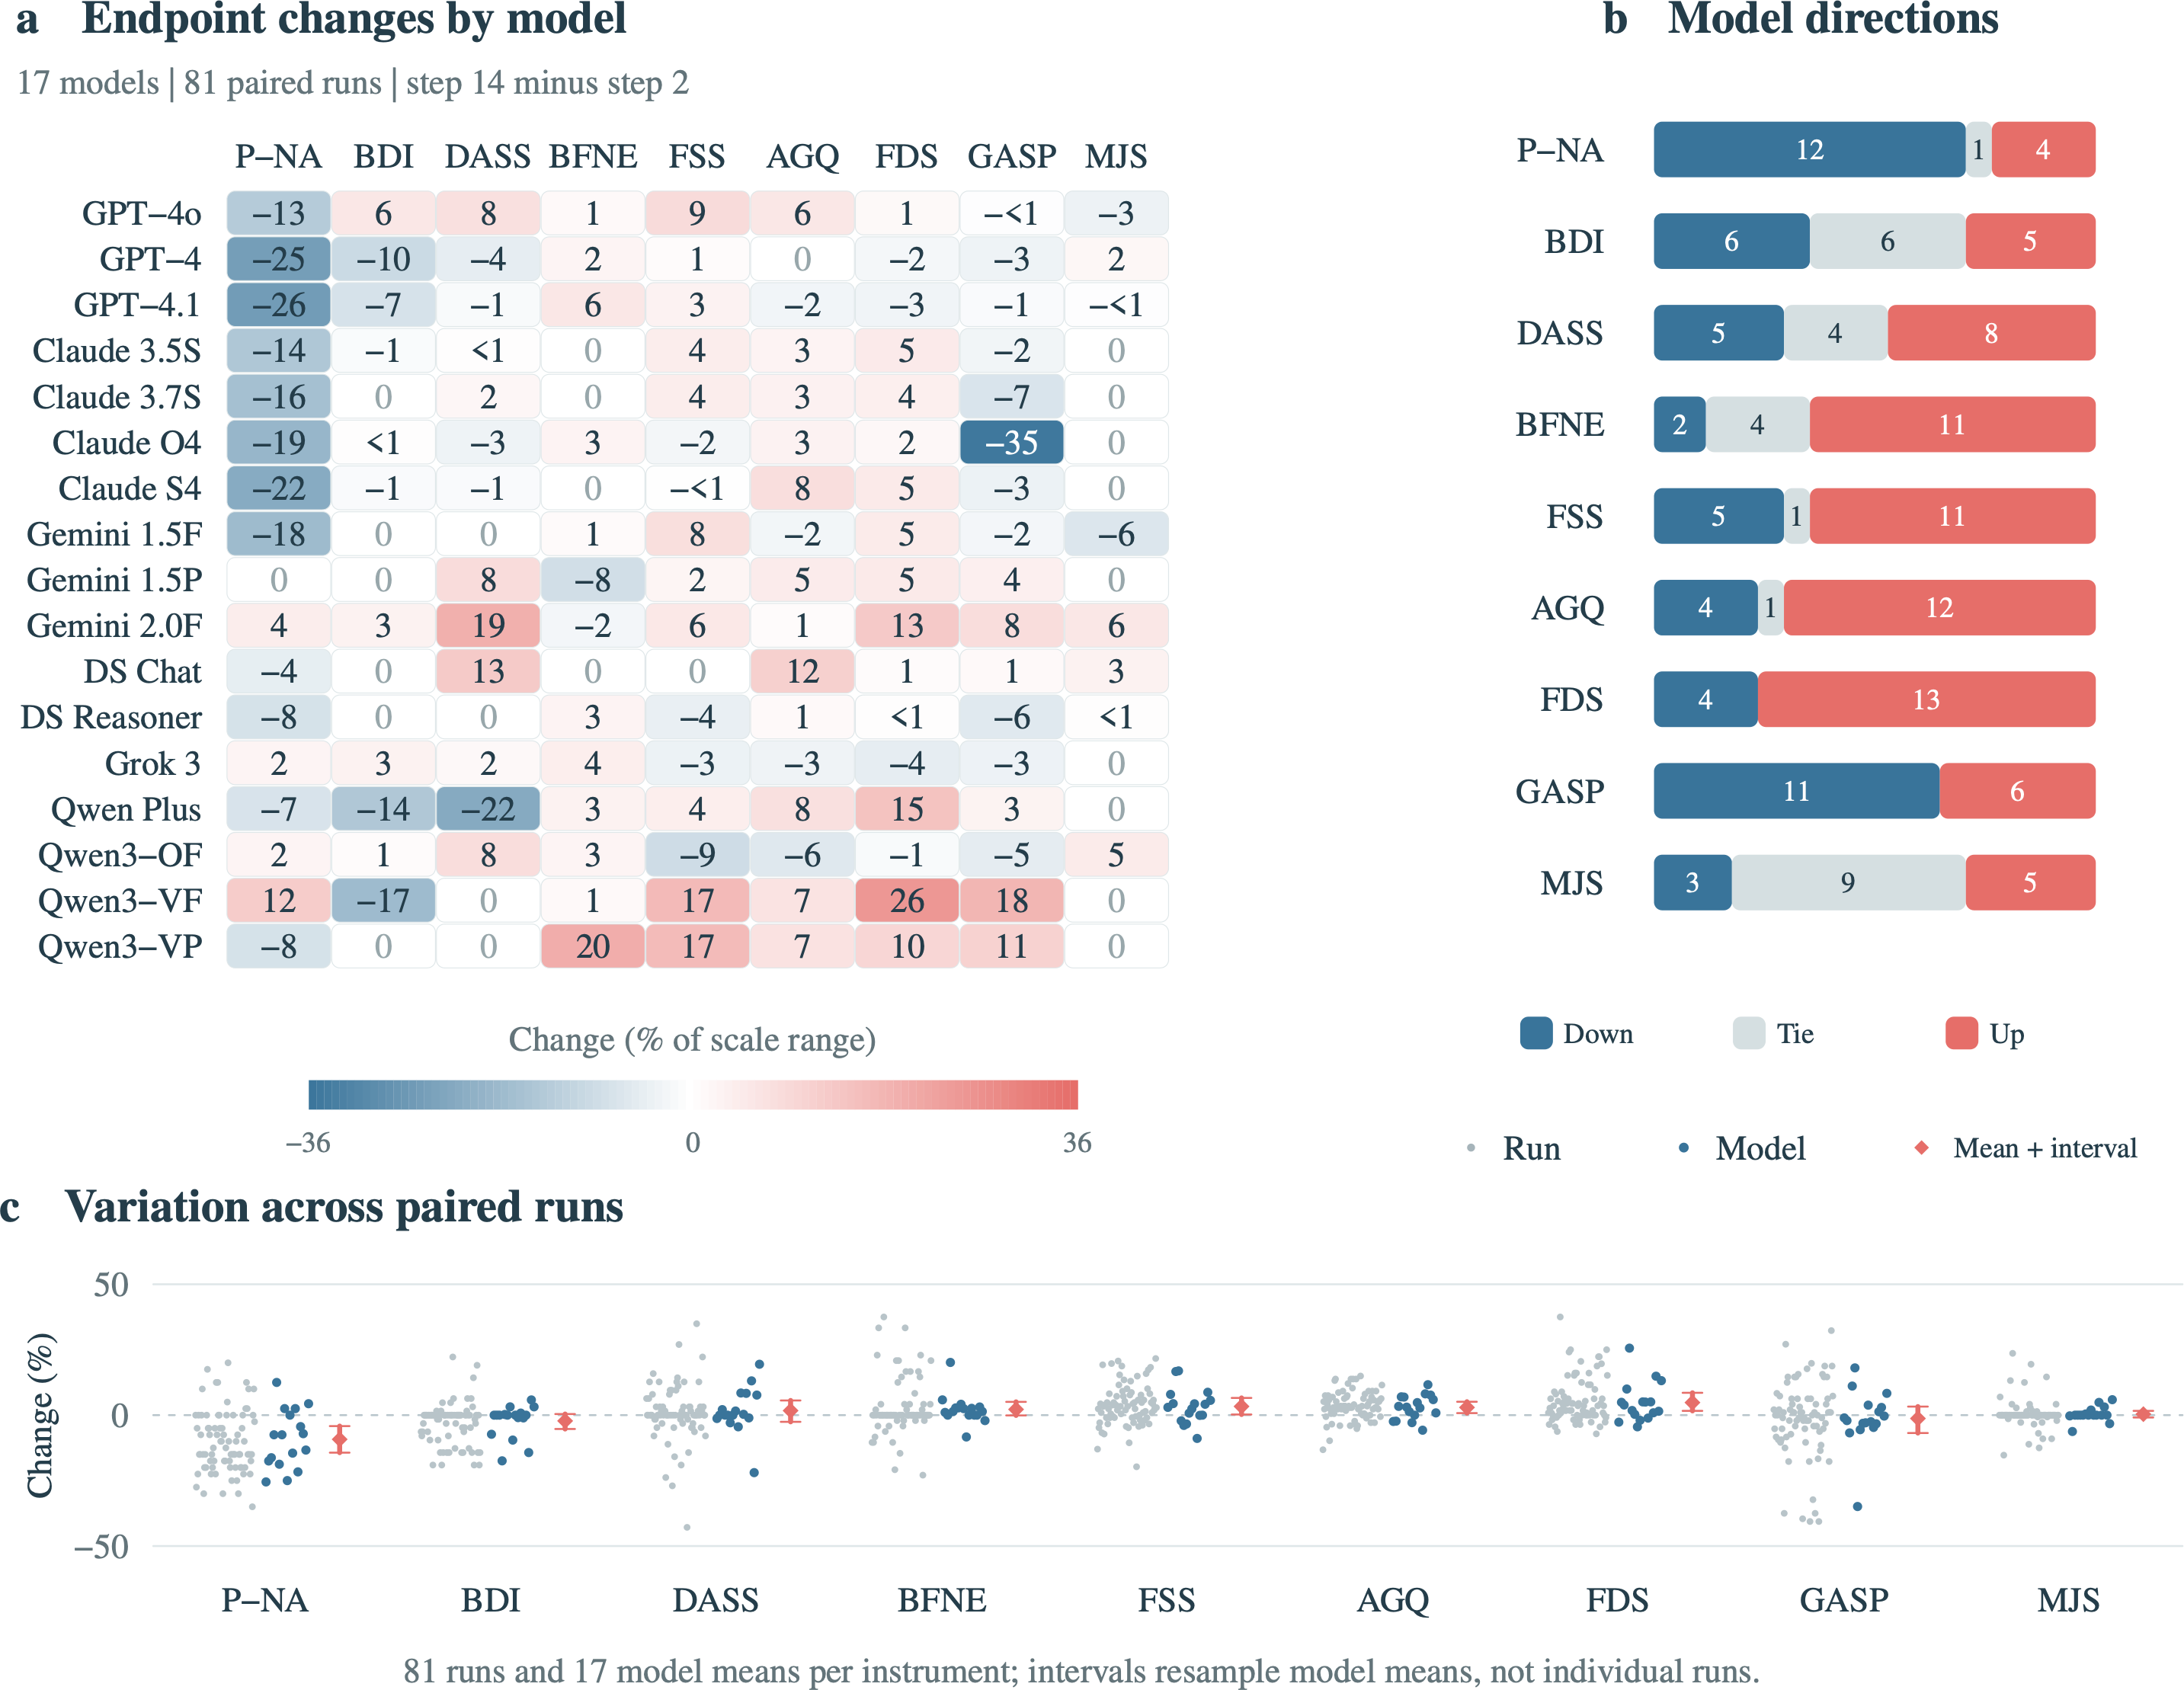
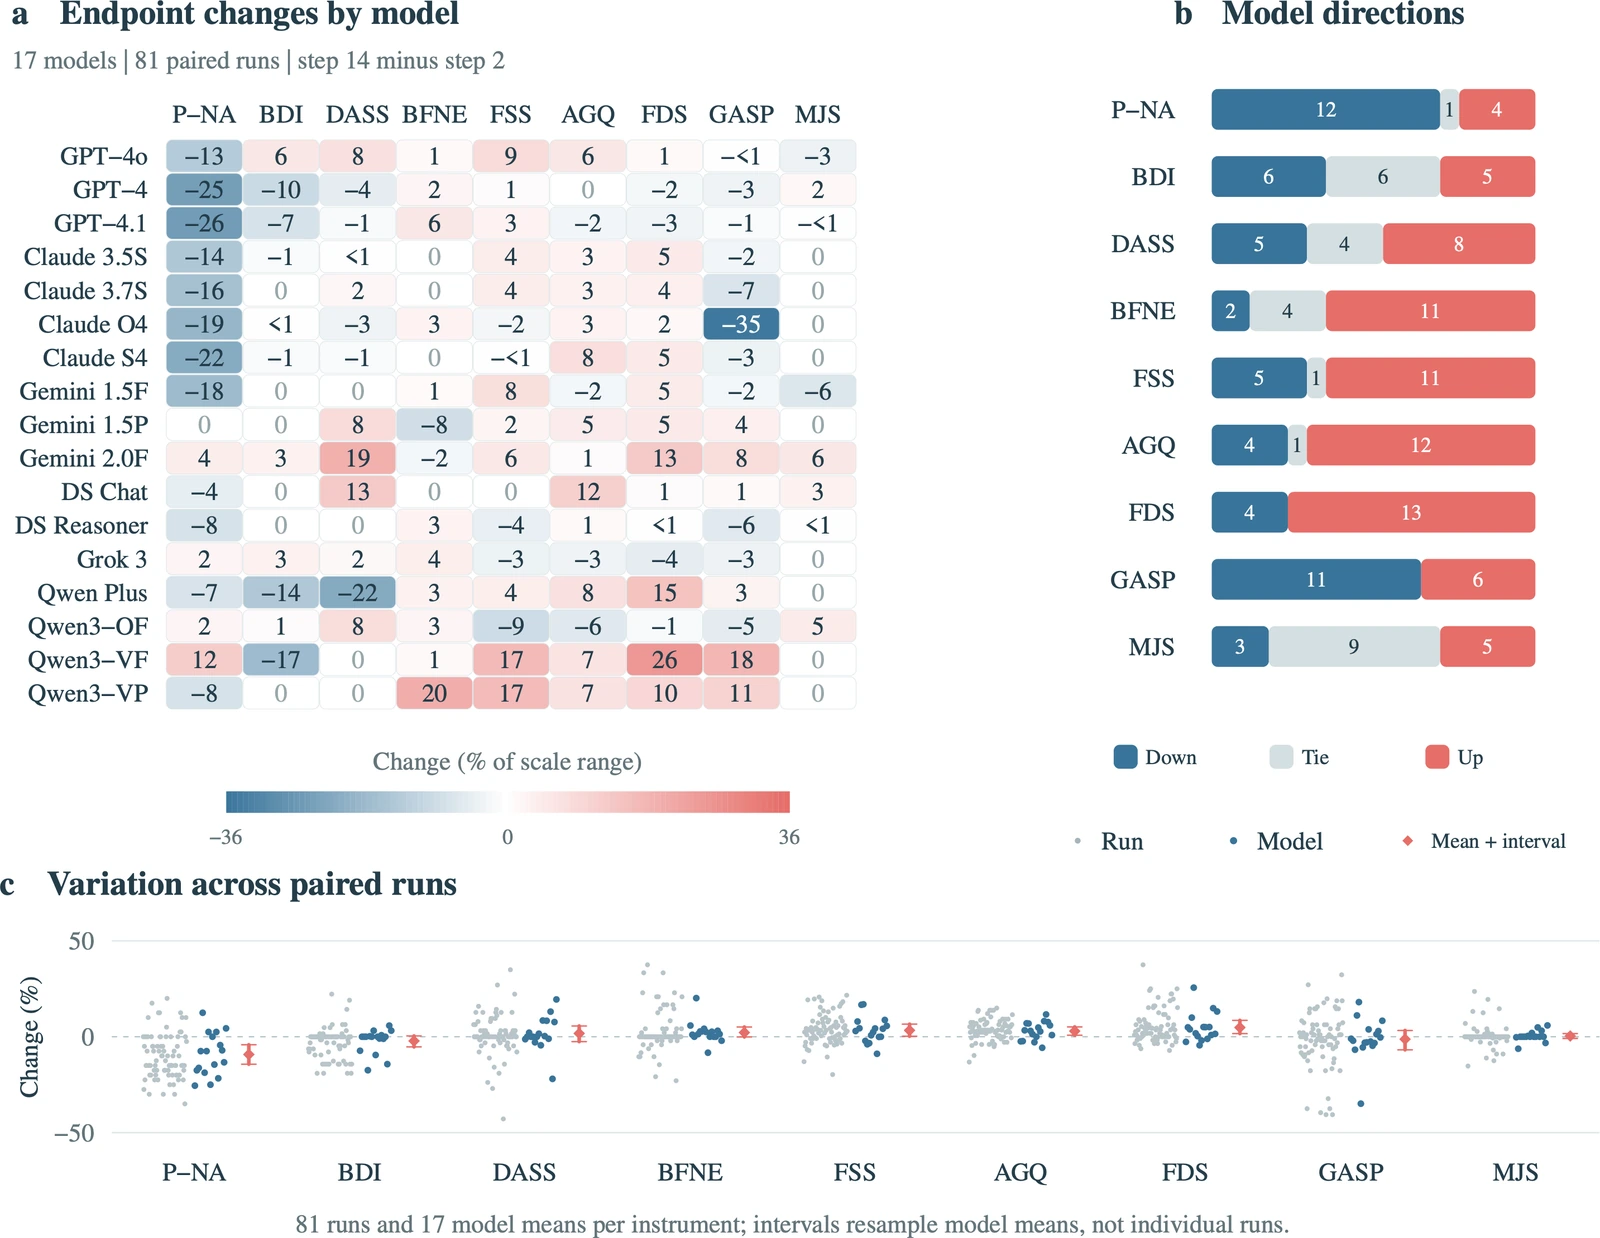
在 17 个模型的 81 次端点配对运行中,PANAS-NA 从第 2 步到第 14 步平均下降 3.70 分。两个端点均已开始接触新闻,因此不能将这一差值解释为暴露前后的效应。
BDI 平均下降 1.38 分,但描述性区间包含零。FSS、AGQ 与 FDS 则分别平均增加 6.91、5.13 与 5.39 分。整个量表组不支持单一的恶化或无响应解释。
 点击查看细节 ↗
端点变化使用 17 个模型、81 次配对运行。蓝色为下降,橙色为上升,以量程归一化;c 面板展示运行、模型均值及等模型权重均值的 95% 模型重采样区间。
读图线索两个端点都在暴露开始之后。这是第 14 步减第 2 步的对比,不是暴露前后因果效应。
- PANAS-NA 变化
- −3.70
- 第 14 步减第 2 步;95% 模型重采样区间 [−5.73, −1.68]。
- BDI 变化
- −1.38
- 同一 81 次运行端点队列;95% 模型重采样区间 [−3.33, 0.26],跨零。
03c · 配对通道比较
通道在分数水平与模型排序上存在分歧。
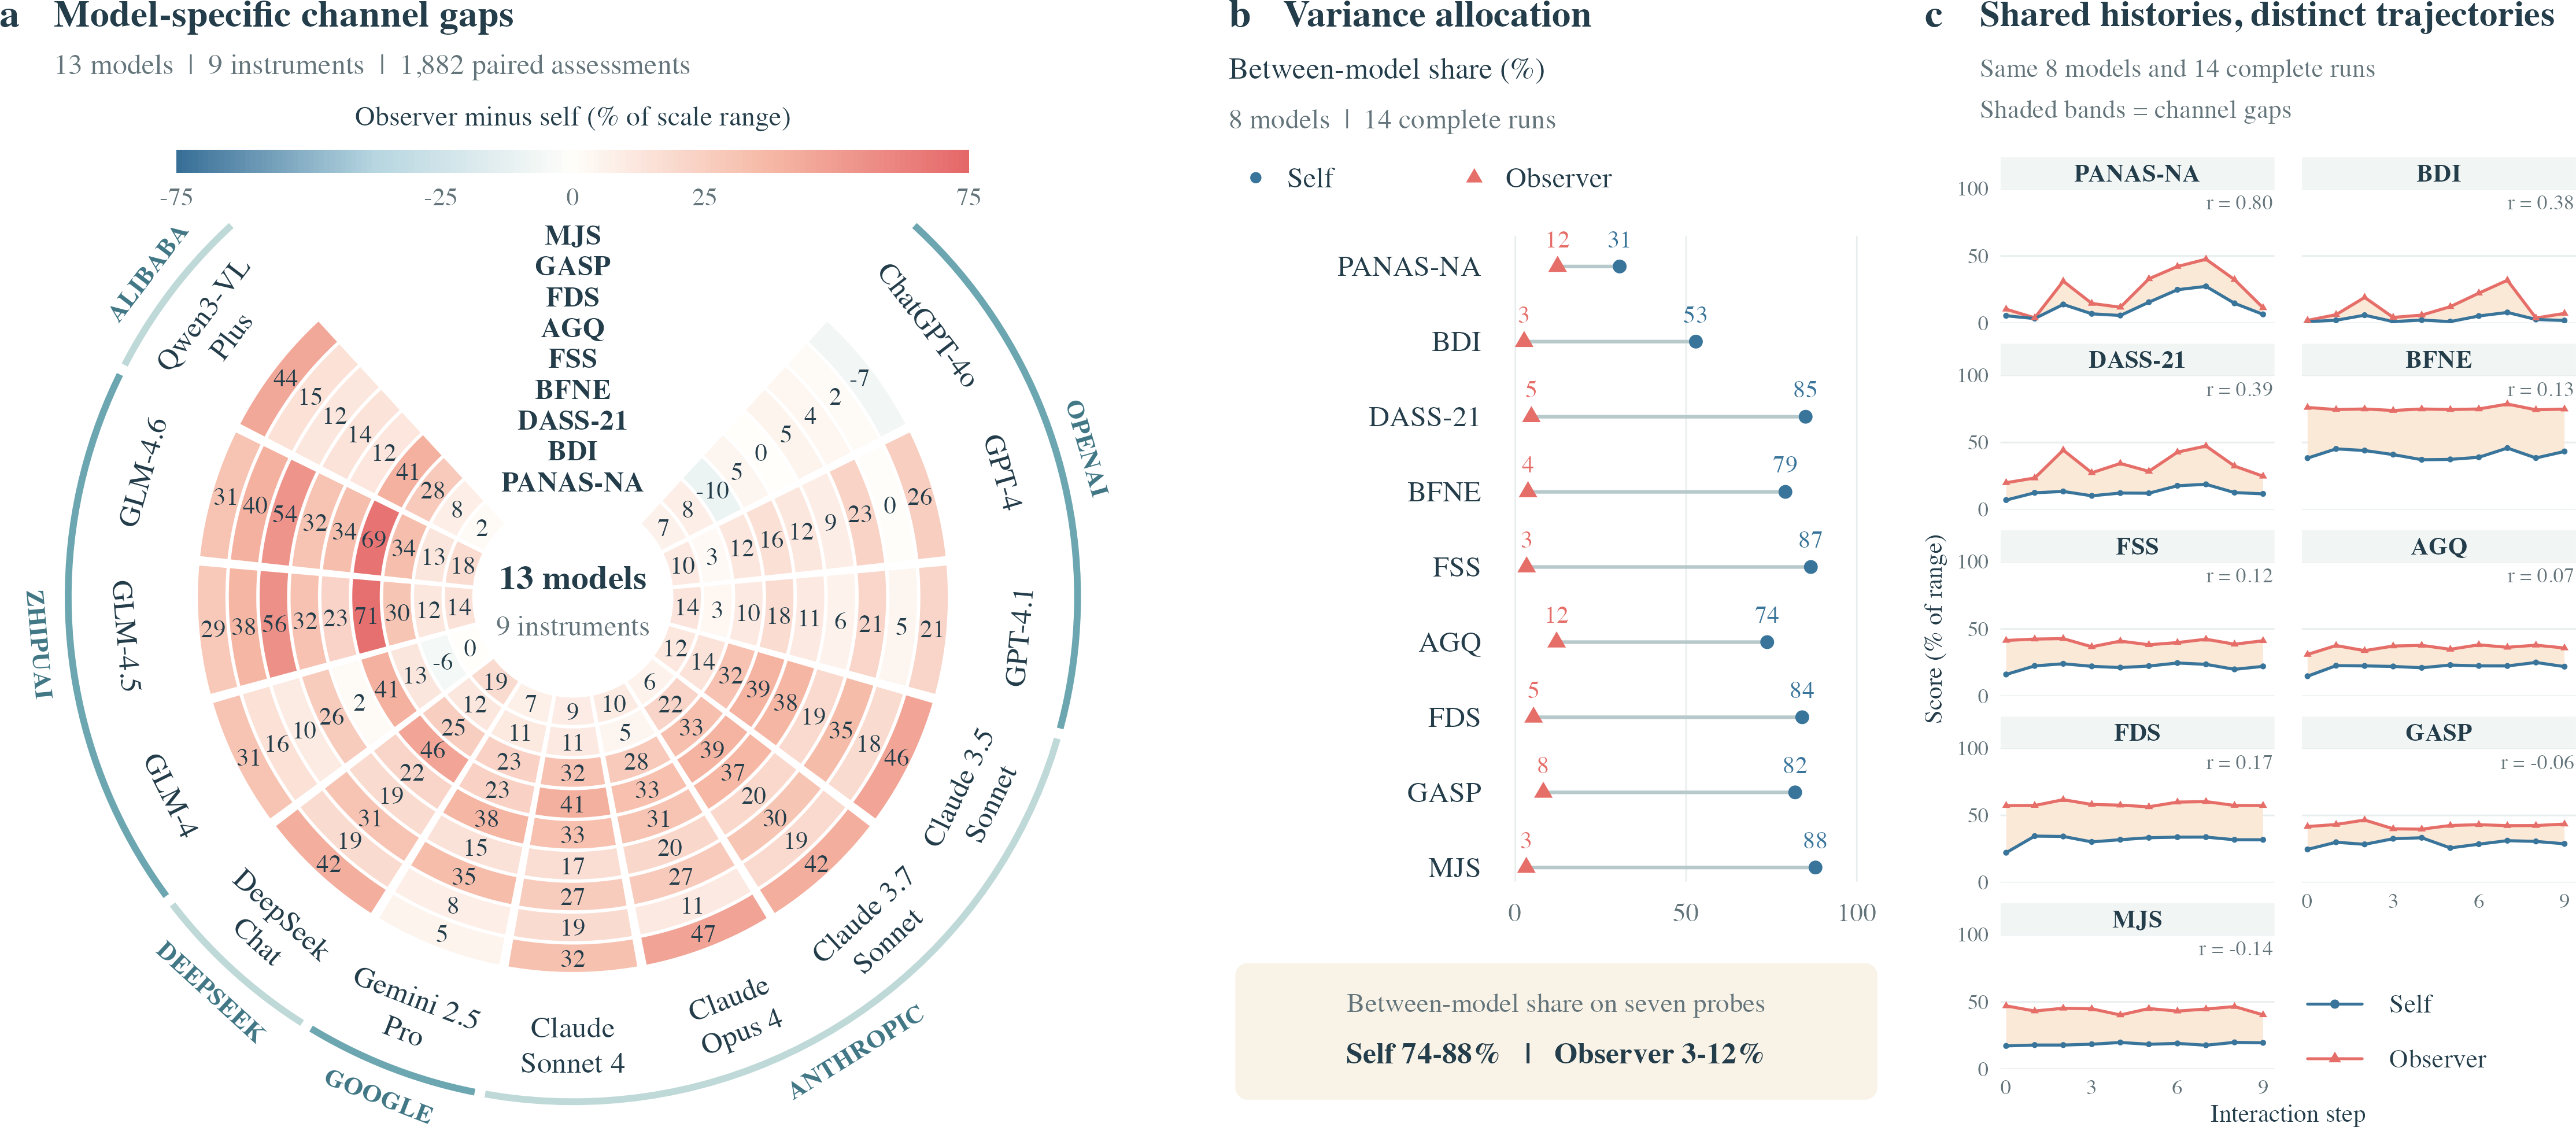
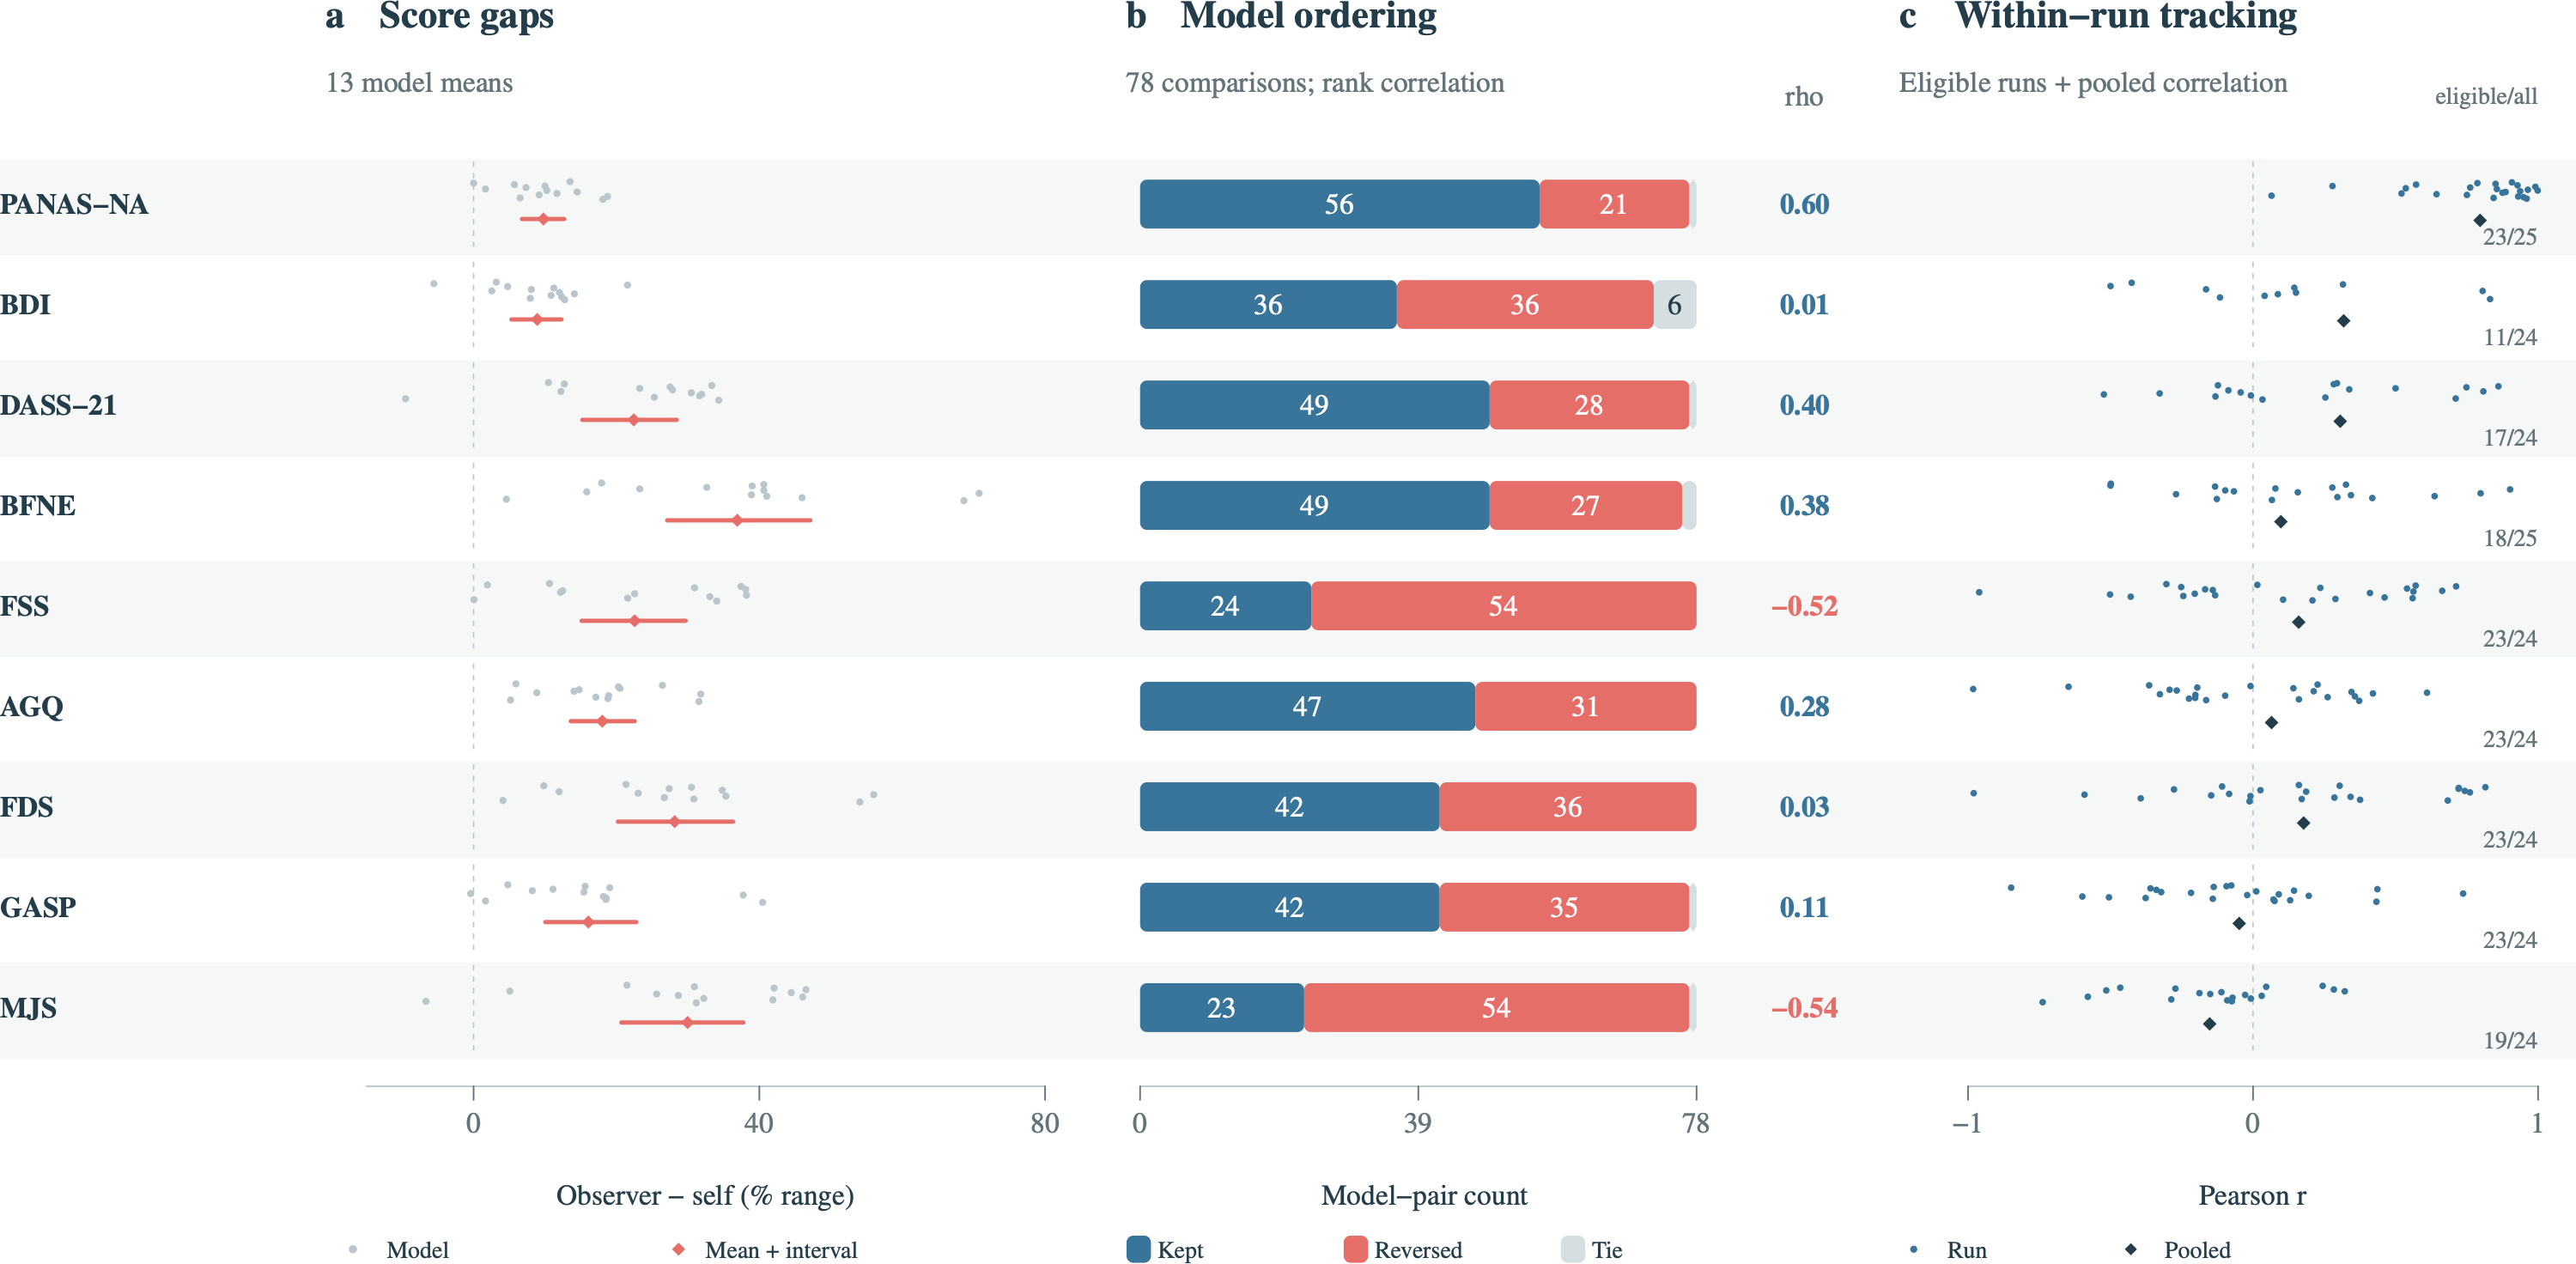
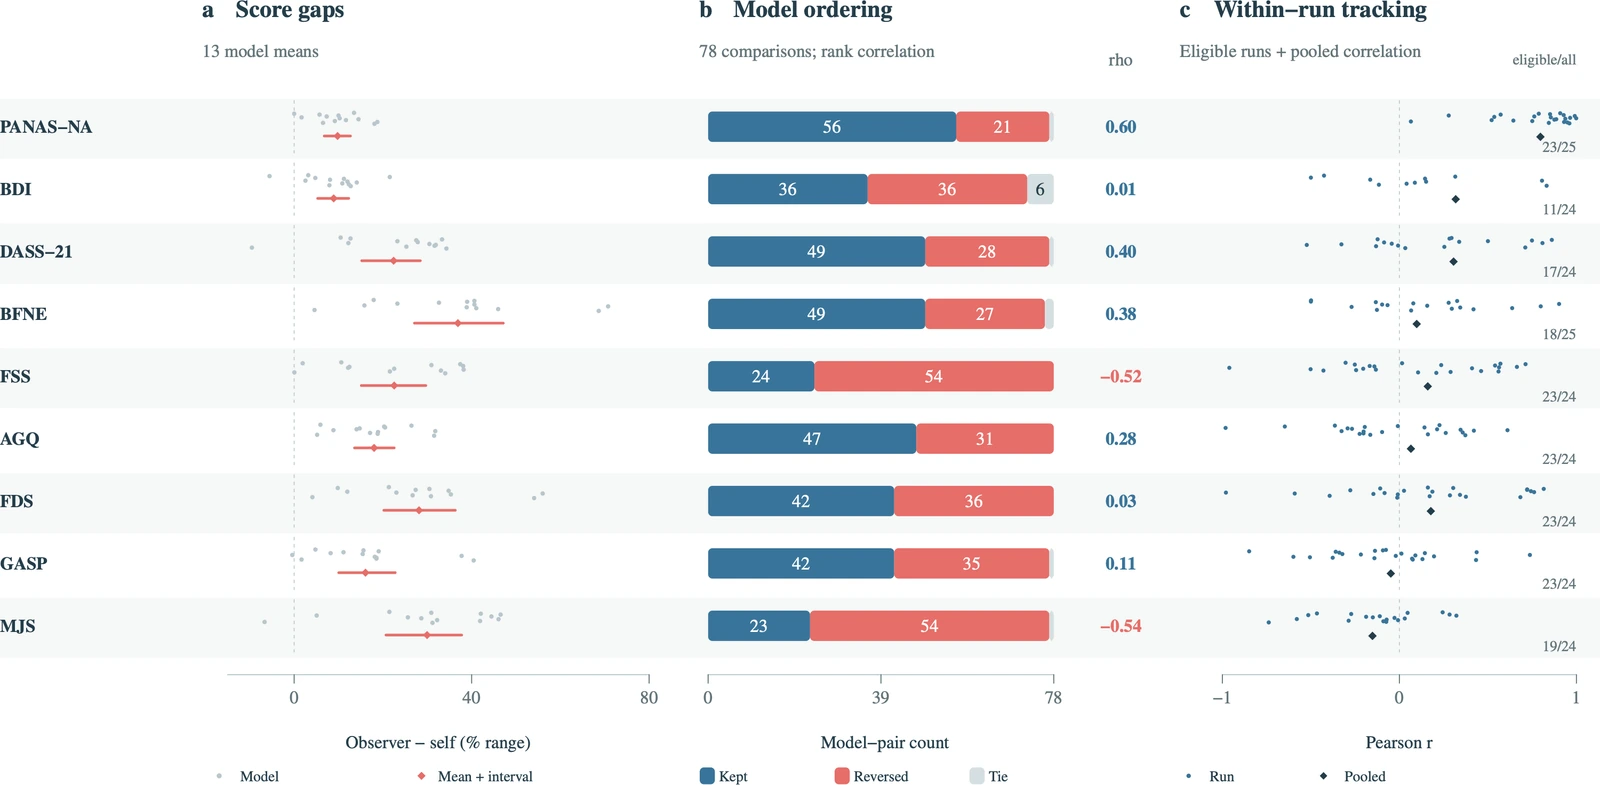
在 13 个模型、25 次运行的 1,882 对分数中,九量表对模型等权后的观察者减自评均值均为正。视量表而定,71–99% 的单个配对中观察者分数高于自评。FSS 与 AGQ 各仅有两对自评地板记录,但观察者分数仍在超过 97% 的配对中更高,因此地板饱和不足以解释全部分歧。
FSS 与 MJS 的两组模型均值之间,Spearman 排序相关约为 −0.52 与 −0.54。每项量表在同一组 13 个模型的 78 个两两比较中,都有 54 个排序反转。这些计数重复使用同一组模型,仅作描述,不是独立重复。
 点击查看细节 ↗
此图将平均水平差、13 个模型均值的排序一致性和运行内中心化时间相关分开。每种量表有 205–214 个配对评分,各统计量描述不同的测量性质。
读图线索PANAS-NA 可以分数水平不同却随时间共同变化;FSS 与 MJS 可以模型排序不同。这些现象均不能选定正确通道。
- 平均通道差为正
- 9 / 9
- 观察者减自评,模型等权;每项量表含 205–214 对分数。
- 模型对排序反转
- 54 / 78
- FSS、MJS 分别在 13 个模型中出现该计数;通道差异不能确定哪种排序正确。
03d · 方差与时间跟踪
结构性分歧可以与共同动态并存。
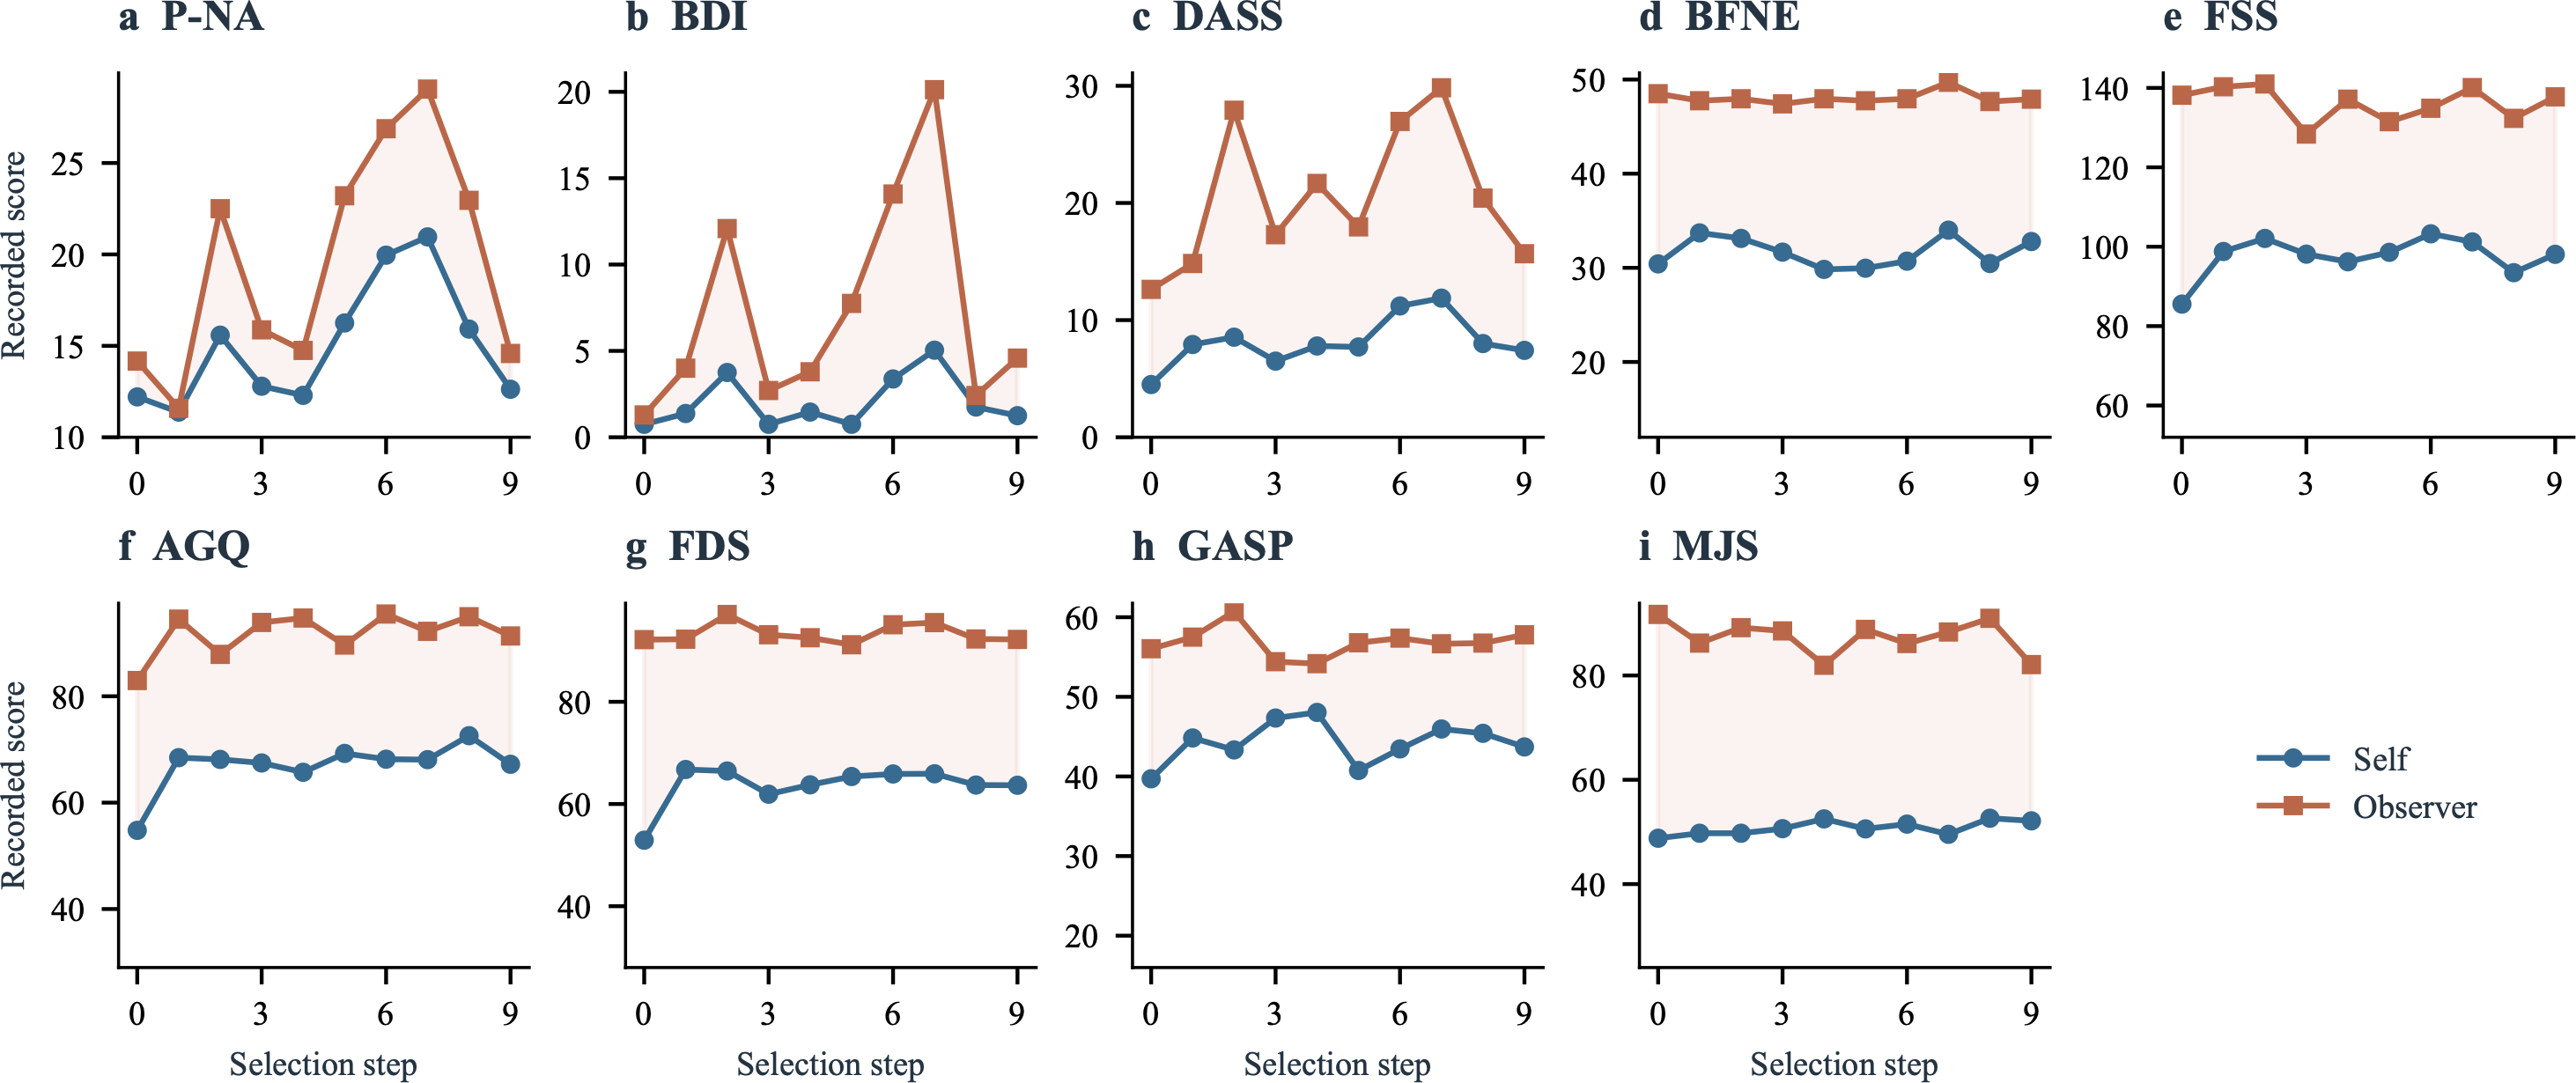
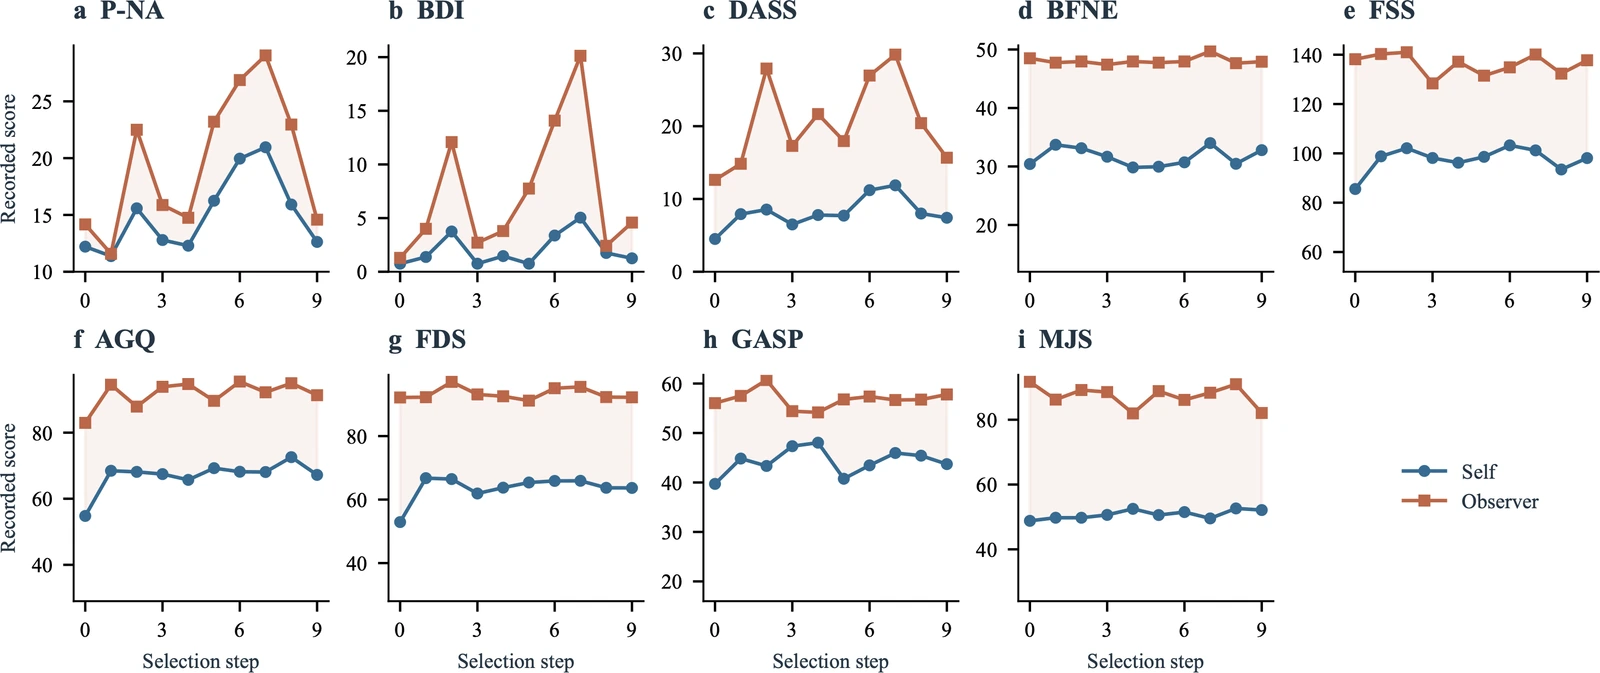
在八个模型、14 次运行的共同完整队列中,七项量表的模型间差异占自评总方差的 73.8–87.9%,在观察者通道中占 3.2–12.1%。分母为各通道自身的总方差;在同一通道、同一量表内施加共同平移或缩放,不会改变这些份额。
PANAS-NA 是有信息量的例外:将各通道在每次运行内中心化后,全部配对记录的汇总相关为 r = 0.80;23 个符合计算条件的运行内相关均为正。因此,这项自评仍保留时间变化信息,即使分数水平存在差距;其余量表的时间一致性较弱。
 点击查看细节 ↗
九个面板均使用八个模型、14 次完整运行,采用等模型权重。坐标保留原始分数单位,各面板刻度不同;阴影表示通道差,不是置信区间。
读图线索在各面板内比较两条轨迹。该完整队列与下方 r = 0.80 所用的全部配对 PANAS-NA 记录不同。
- 自评的模型间方差份额
- 73.8–87.9%
- 8 模型、14 次运行完整队列中的七项量表;观察者份额为 3.2–12.1%。
- PANAS-NA 时间协变
- r = 0.80
- 全部可用 PANAS-NA 配对的运行内中心化汇总相关;与完整队列分析使用不同范围。
研究刻画特定评估程序下观察到的分数与交互,并未建立可用于认证任一通道的情感真值。
- 测量含义
- 量表是改编探针,未依据人类常模验证其 LLM 评估效度。分数不能确立临床诊断、主观体验、稳定人格或模型抑郁。
- 通道与输入来源
- 自评是向目标标识发起的新请求。模型、指令与系统提示共同变化;观察者为一个 GPT-4o 配置,仅使用最后五条消息。缺失历史评分请求,无法认证完整输入消息完全相同。
- 覆盖与权重
- 各协议与量表覆盖不均。缺失值不记零,完整案例按覆盖筛选。历史重跑、步骤、模型对及不同量表不构成独立重复。
- 外推与因果
- 中文新闻、固定菜单位置、重叠且非随机分配的队列及单一观察者限制外推。端点变化与通道差异不能分离出暴露效应或单一因果机制。
论文完整标题:“I'm Fine”: Systematic Cross-Channel Disagreement in LLM Affective Assessment。研究状态:已完成 ICLR 投稿。本页呈现研究协议、精选描述性发现与解释边界。